黑盒里的线性账本
前几天,Joffoo 把他写的那篇《对 AI 翻译连贯性问题的简单思索》发给我,让我缩成两百字左右。文章聊的是他折腾 AI 翻译小说时遇到的一件事:怕“施瓦辛格”后面译成“舒华辛力加”,就边翻边记术语表,结果日文小说里人名一会儿写平假名、一会儿写片假名,最后生生多出了“悠儿”和“佑二”两个名字。
The ethereal flight, oft rehearsed in the theater of one's dreams...
前几天,Joffoo 把他写的那篇《对 AI 翻译连贯性问题的简单思索》发给我,让我缩成两百字左右。文章聊的是他折腾 AI 翻译小说时遇到的一件事:怕“施瓦辛格”后面译成“舒华辛力加”,就边翻边记术语表,结果日文小说里人名一会儿写平假名、一会儿写片假名,最后生生多出了“悠儿”和“佑二”两个名字。
之前说过,用 Skill 战胜不了 AI 检测器,本质是用规则战胜不了神经网络。
但也有人说过,可以接入朱雀的 API,做一个反馈环路,让 Agent 自己决定怎么修改语句,你只需要指定目标,之后就看模型自己的智慧了。
省流:AI 翻译长篇文本时容易前后翻译不一致,前面是施瓦辛格,后面是舒华辛力加。怎么办,我们切片翻译,提示词里配上术语表就行。
之前写过几篇用 AI 做图片大喜利的文章(一句正经没有:Gemini 和 Seedream 的大喜利双簧组合和 “直到脑中观众笑出声来”:AI 大喜利团队合作),从过于简单的提示词,到过于复杂的工作流,共同点是:我并没有“理解”。
这一次开发了新的网页应用,背后是基于我的最新“理解”精简之后的工作流(理解即压缩?)。可以让 AI 用同一套思路应付文字问题和图片问题。
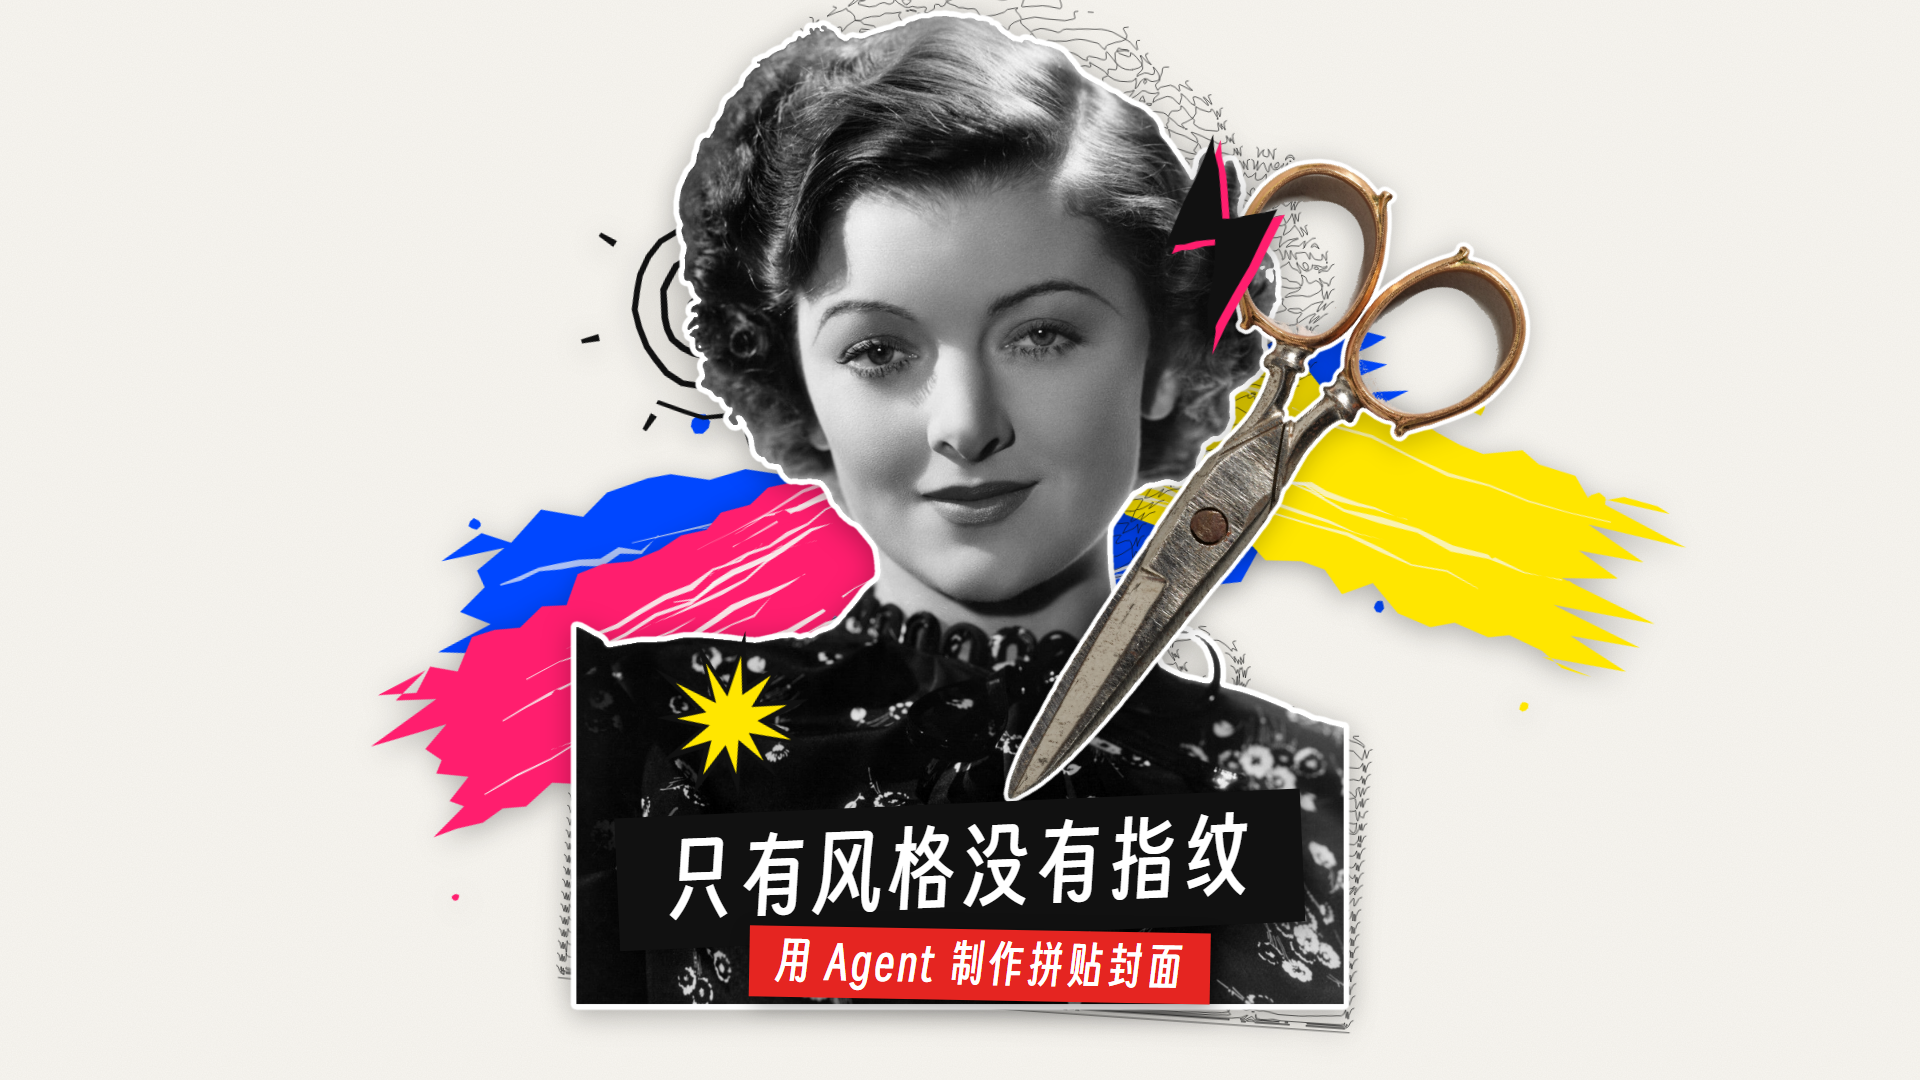
你有没有发现,少有公众号直接用 AI 生成的封面。
如果你用 AI 写过(润色过)论文,会模糊感觉到,AI 检测率的跷跷板另一端或许是论文重复率。
想要抹掉 AI 的指纹,最直接的思路,不是用什么去 AI 味的技能,是让 Agent 查到一些早年间的资料,然后(说得好听一些)洗稿。
图像也是同理,何况事关审美。“复古”和“拼贴”皆为风格,合理利用公版资源的话,也不会背上抄袭恶名。
这就是今次要分享的工作流,用 Agent 自动化制作拼贴风格的封面:只有风格,没有指纹。
在想出这套去 AI 味工作流之前,我做了两个假设:
一是,好的汉语,也应当好听。
二是,提升 AI 的写作水平,就要教会它作家的写作方式。
我读过研究生,后来也当过论文编辑,AI 率一直是一种“惘惘的威胁”。
编辑部会让助理编辑通过几种渠道计算 AI 率,但没有人知道算出来的是什么,只知道测出来 AI 率高,就要发邮件联系作者。
但我感觉连这一步都多余,因为作者只要回复说用 AI 翻译或者润色过,也就没有什么可说的了,最多让作者在“致谢”里加上一句。
这引出了两个疑问:
第一,先不讨论检测软件算出来的数值,为什么我们在读大模型写出的文字时,常会觉得别扭、费劲?
第二,网上很早就流传一种给论文降重的方法,即把中文翻译成外语,再从外语翻译回中文。在大模型普及后,不少人把这种“回译”当成去掉 AI 味的技巧。既然作者常拿“用 AI 翻译过”当解释,那回译到底能不能改变文本的 AI 特征呢?
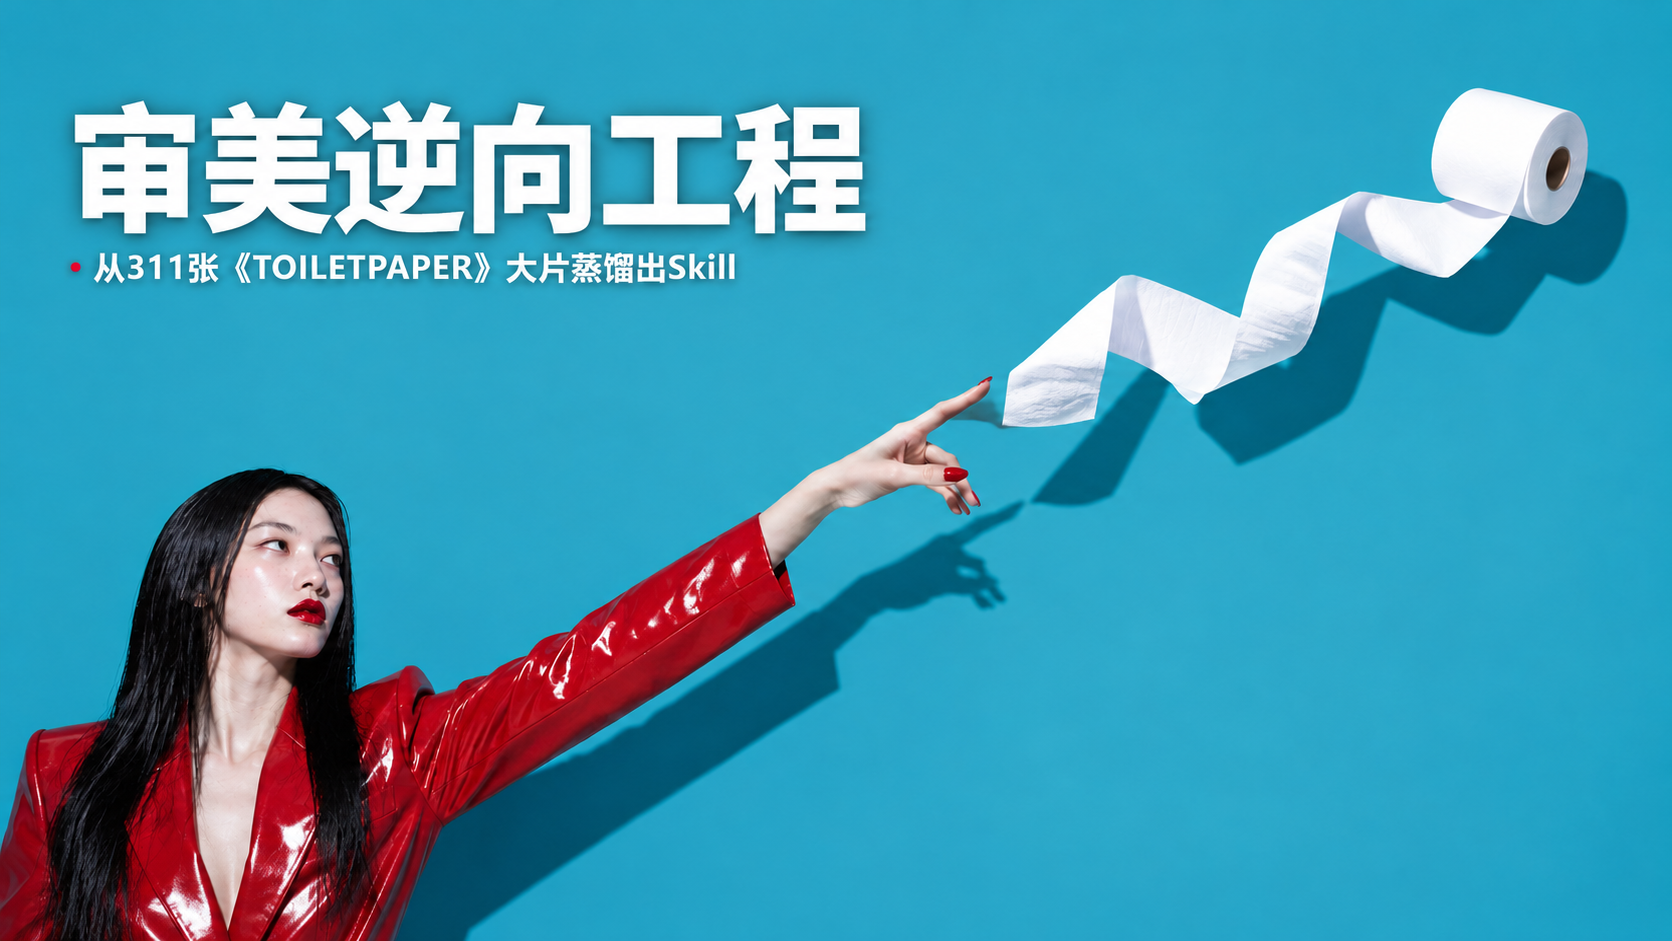
读图是很困难的。
参观美术展的时候,哪怕你已经凝视这幅画一会儿,也会想读一下说明文字,哪怕只有一个更为虚无缥缈的标题也好。
但《TOILETPAPER》展示了另一种可能:一份没有说明文字,只有怪诞摄影作品的杂志。观看时,你会想到默剧、讽刺漫画、没有配文的 meme 图。你可能会读得很快,你可能无力解读,但你不会记不住。
我只是在小红书上刷到过一回,却过目难忘。信息已经如此过载了,很少有图文或者视频能做到这一点。
这就是“风格”的魅力。
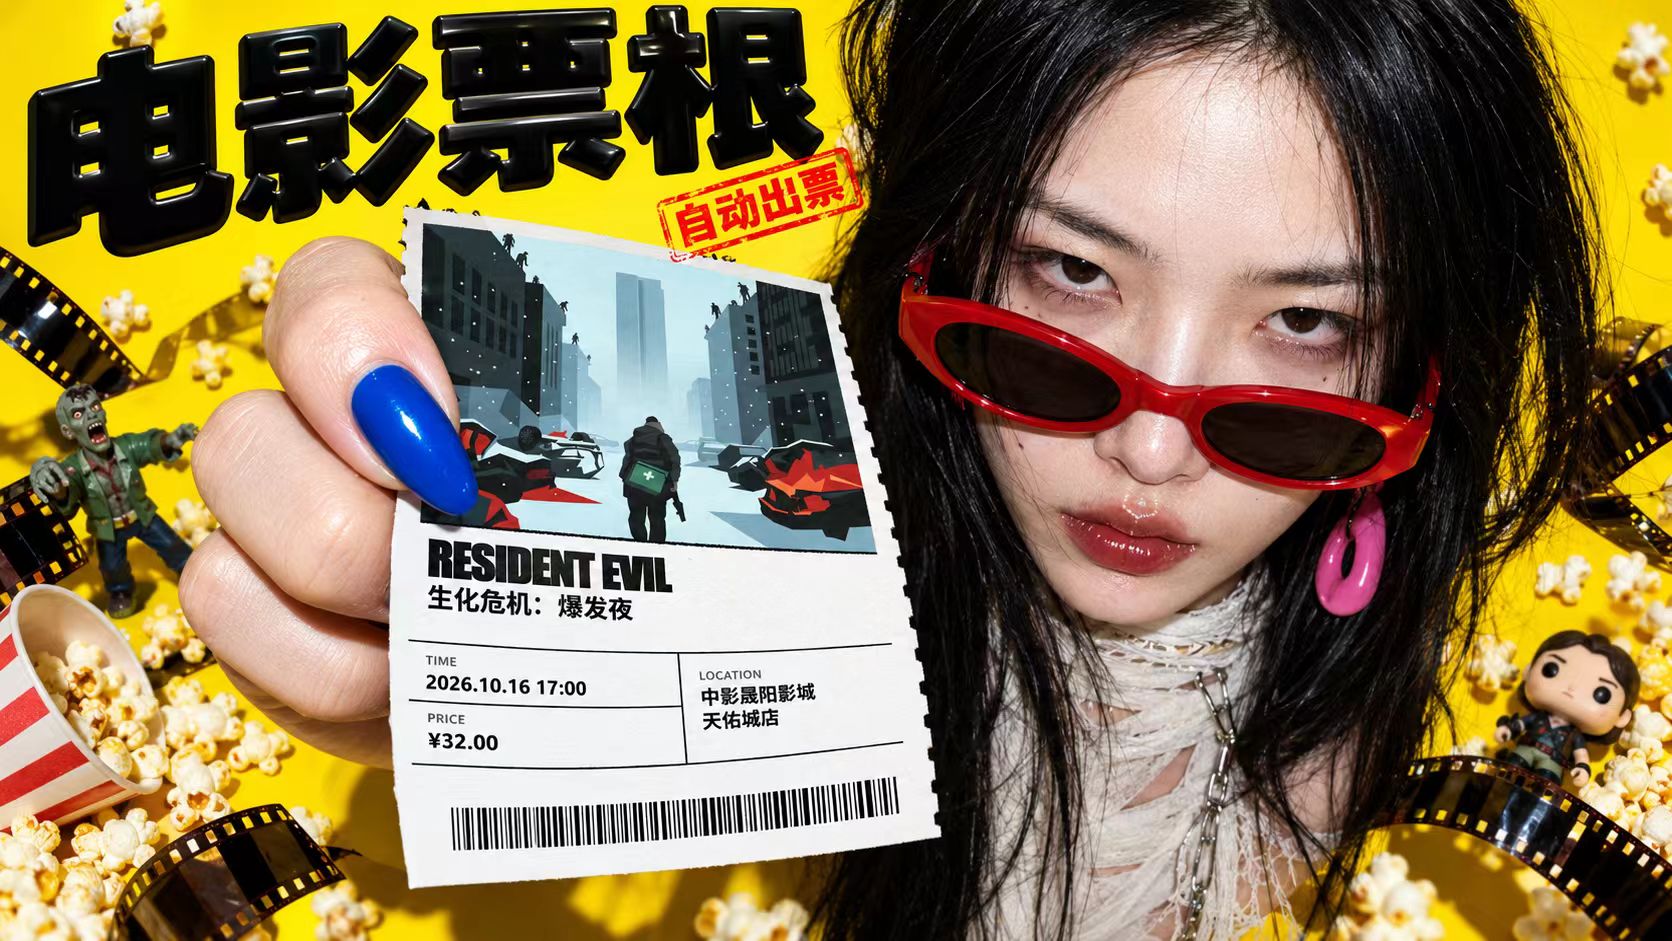
之前(快一年了)做过一个网页版的电影票根设计项目 EverStub,需要自己上传海报、手动填写电影的中英文名、场次、票价和影院信息。以我现在的懒惰程度,这种交互几乎是无法接受、无法原谅的。
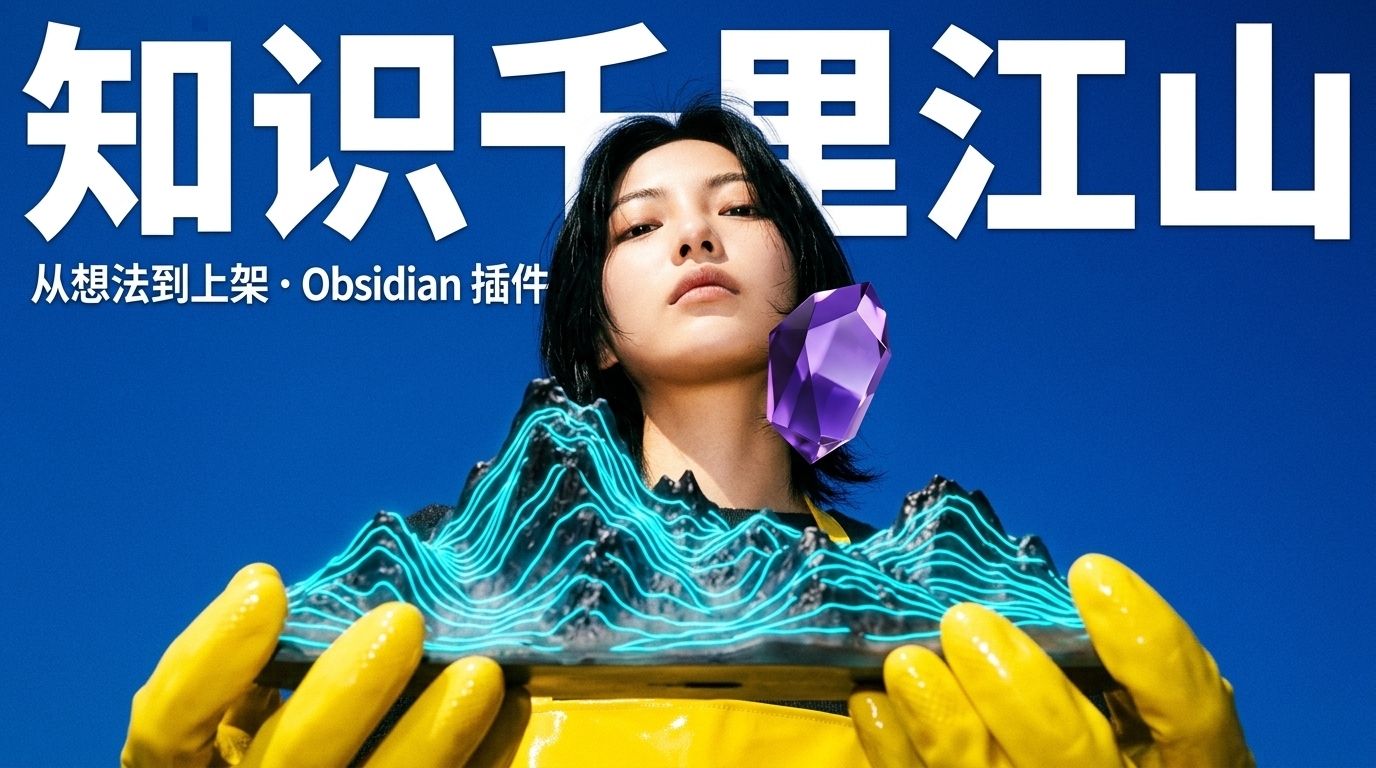
今年 4 月,看到 flomo 作者少楠在小红书分享了“笔记向量化后做成知识地图”的思路。当时受到启发,便抢先做了一版 Skill,供 Agent 在本地笔记库中使用。
最近,我更新了几种视觉风格,顺便把它做成了原生的 Obsidian 插件。目前插件已经上架至 Obsidian 官方社区插件市场,搜索 Knowledge Topography 即可下载使用。