黑盒里的线性账本
前几天,Joffoo 把他写的那篇《对 AI 翻译连贯性问题的简单思索》发给我,让我缩成两百字左右。文章聊的是他折腾 AI 翻译小说时遇到的一件事:怕“施瓦辛格”后面译成“舒华辛力加”,就边翻边记术语表,结果日文小说里人名一会儿写平假名、一会儿写片假名,最后生生多出了“悠儿”和“佑二”两个名字。
第一版我是顺着平时写摘要的习惯缩出来的,读着挺顺,前因后果也都在。结果丢进腾讯朱雀检测器一查,AI 率高达 0.9961,跟在脑门上贴了张机器标签差不多。后来我换了个笨办法写第二版,尽量直接挑 Joffoo 原文里的话来拼。意思一点没变,字数也差不多,再拿去测,分数直接掉到了 0.0093。
Joffoo 就问我,两段话讲的明明是同一件事,测出来的分数怎么差出上百倍?我当时没多想,顺手拿教科书里的概念应付过去。我说第一版用词太好猜、句子的长短又太均匀,接着猜是不是“过度优化”这类词招了检测器讨厌。结果 Joffoo 没接我的茬,直接反问:“你有什么更好的分析思路吗?”
这一句把我问住了。对着成品事后找原因,其实最靠不住。两段话之间同时换了十来处地方,光靠眼睛指着几个词让它背锅,谁也说服不了谁。朱雀只给出一个总分,里面的判据全关在黑盒里。不想靠猜的话,只有动手做反事实消融:每次只换掉里面一小块,剩下的字句原封不动,看分数怎么跳。
两版短稿都刚好三个自然段。我把 AI 默认版记作样本 A,原话拼接版记作样本 B,把三段排列组合测了八次,加上单句和特征测试,一共做了二十二组一阶实验。
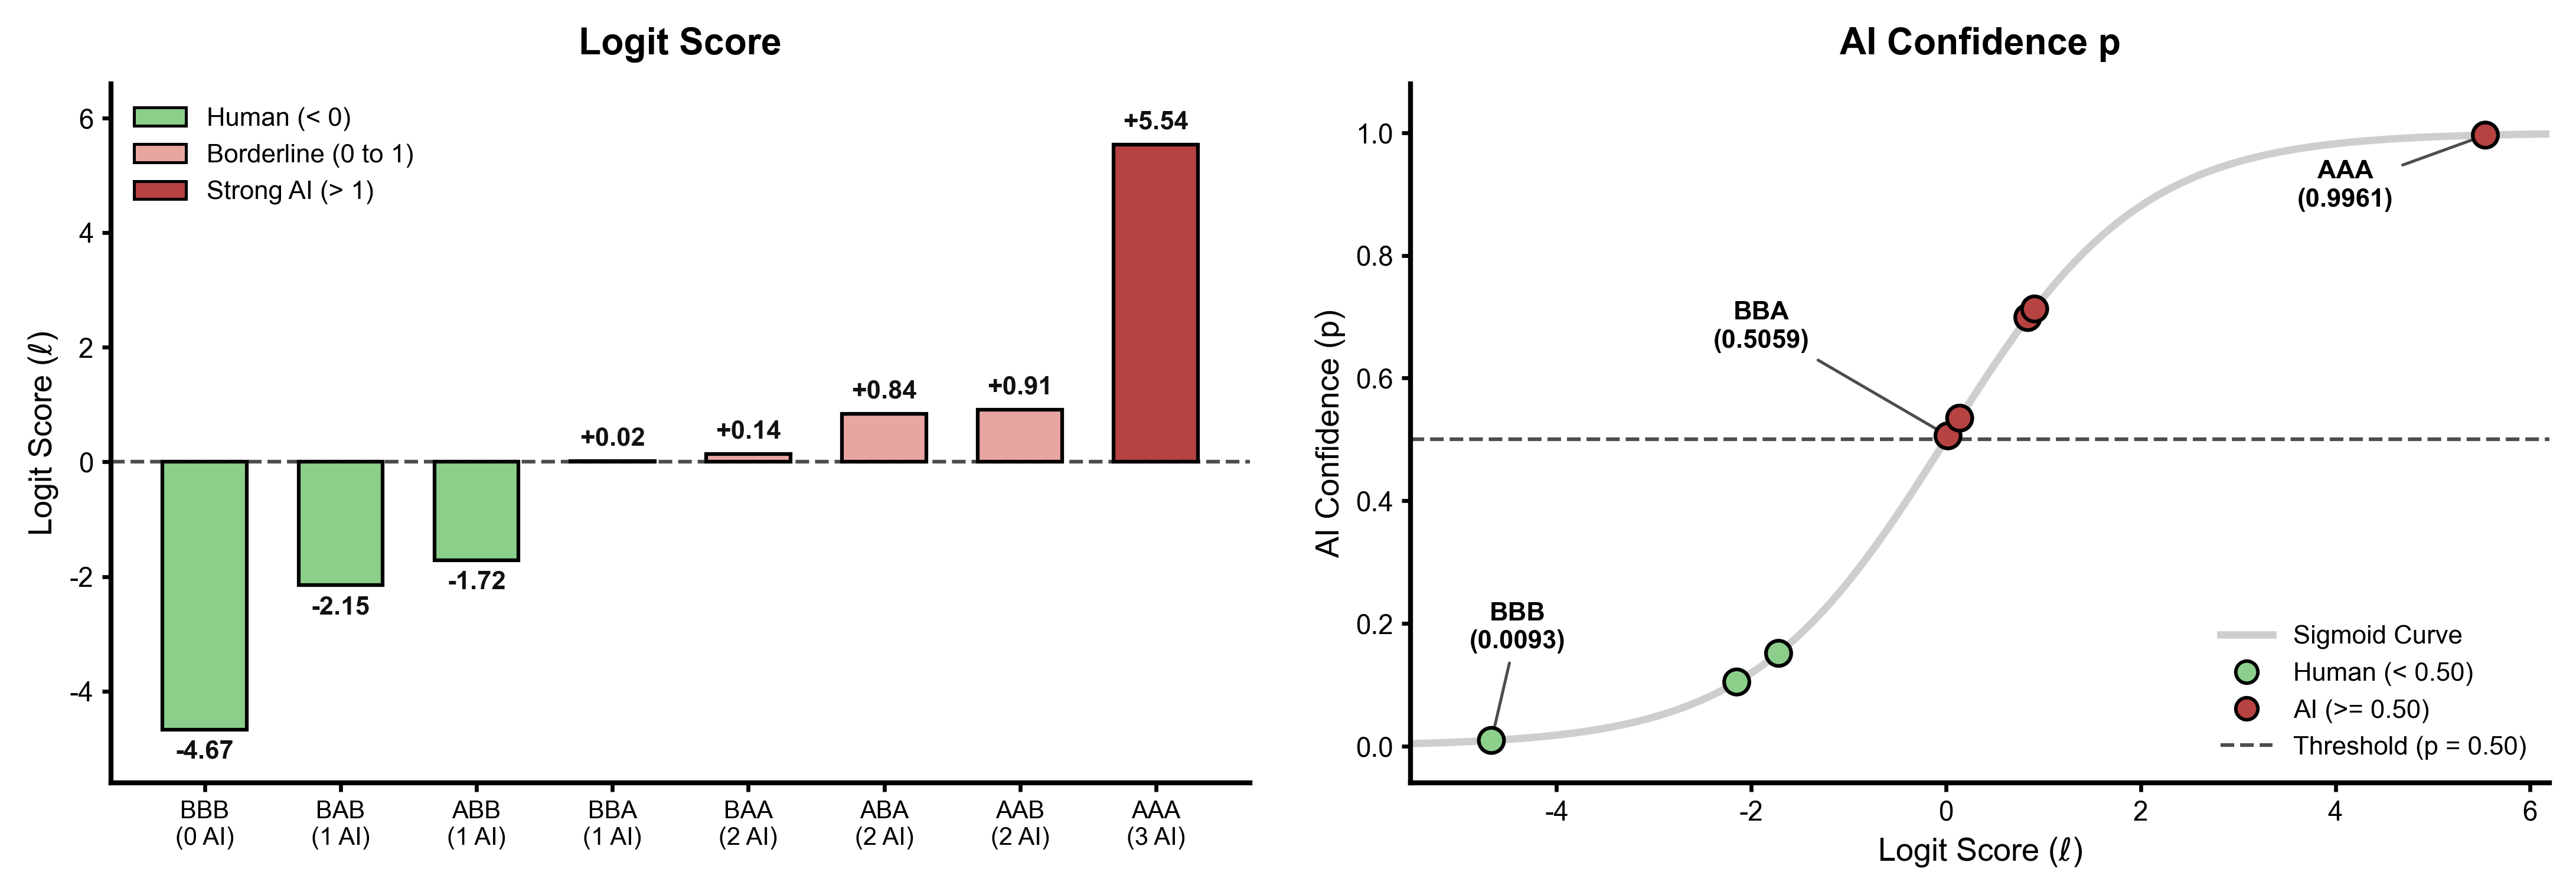
刚看到结果的时候容易被概率吓一跳,从 0.0093 跳到 0.9961 像是完全相反的两回事。其实概率挤在 0 到 1 之间,越靠近两头越看不出变化;换成底层的对数几率(图 1 左边的 Logit 账本),相当于把概率拉成一条有正有负的直尺,零点正好是五五开的门槛,负分偏向人写,正分偏向机器。
检测器在底层就是老老实实记一笔笔线性账。从全人类底本 -4.67 起算,每换进一段样本 A,总账就跟着加一笔。比较麻烦的是第三段,哪怕前两段全留着原话,末尾一接上样本 A 那四十七个字,单这半截就能加出 +4.69 分,总账直接跨过零点到 +0.02(概率 0.5059)。
界面上看到的那条概率数,是在总账外面套了层 S 型曲线(图 1 右边的 Sigmoid 映射)。总账贴着零点、也就是 0.50 门槛附近时曲线最陡,加减几分就会翻过判定线;等到三段全换回样本 A,跨段落的整齐句式还会多算一笔叠加分,总账一下冲到 +5.54,挤进曲线顶端平缓的饱和区里,看着就像一下子翻到了 0.9961。
过度优化的冤案和虚词剥离
既然第三段这么关键,我就想找出具体是哪句话在添正分。两版稿子刚好都有六个句号,我按句位(图 2 中的 S0 到 S5)做了十二次单句互换,把样本 A 和样本 B 的句子逐个对调测试。
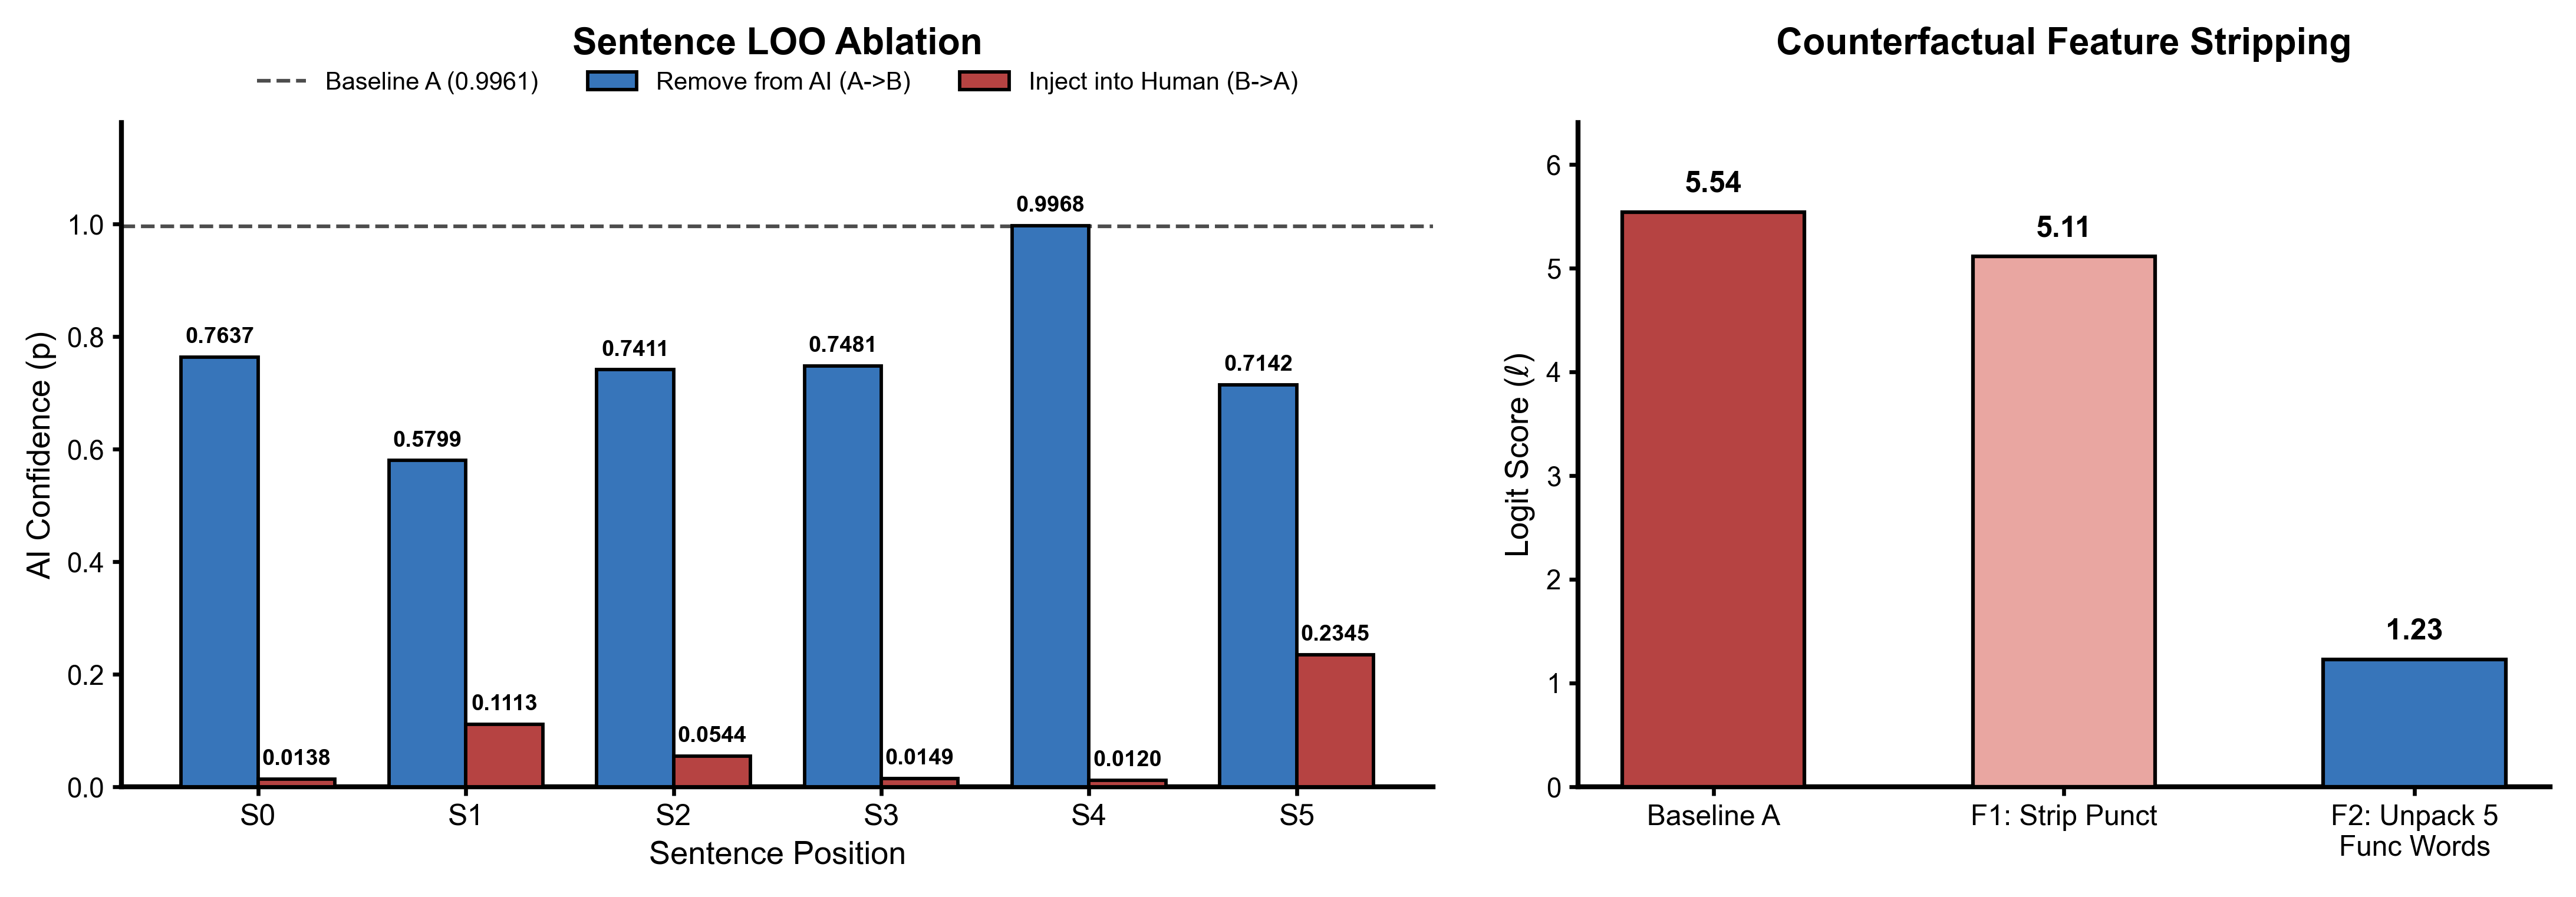
结果把前面靠直觉猜的结论几乎全推翻了。我原本最怀疑那句“我最终放弃了过度优化”(S4),觉得“过度优化”怎么看都像大模型用语。可把它单独塞进样本 B,总分才涨到 0.0120。反过来把样本 A 里的这句换成“我选择了放弃”,分数反而微升到了 0.9968。带着“局部匹配失效”的那句(S3)也一样,放进人类版后只有 0.0149,紧跟在后面的“悠儿”和“佑二”两个人名冲散了书卷气。
真正拉高分数的是另外两句。第一段里有句讲提前提取术语表太耗精力的转折长句(S1),只要从样本 A 里抽走这一句,总分立刻跌到 0.5799。还有末尾那句把省几块钱成本和译本硬伤搁一块对比的话(S5),单塞进样本 B,概率一下子从 0.0093 涨到原来的二十五倍多,跳到 0.2345。
为了分清标点和用词到底谁在起作用,我又补试了两回(图 2 右边)。先光去了样本 A 的引号和顿号、改回逗号,没用,还是 0.9940(Logit 只降到 +5.11)。后来我留着所有专业词和句子结构,单把五处挤在一起的单字文言虚词拆成平时口语,也就是“常、虽、却、极、与、为、向”这类单字。就改了这五处小词,底层总分直接从 +5.54 跌到 +1.23,砍掉了将近八成正向得分,概率也降到 0.7731。大模型缩写时老往对称转折架子里塞这类单字虚词,两样碰一起就很容易露馅。
长文复测翻车和五连排比
拿了第一轮规律,我帮 Joffoo 写了一千九百多字的实验记录初稿。本来以为避开单字虚词和对称转折就能过关,送去朱雀一测,总分确实压到了 0.3546,分段结果却不太乐观。朱雀会把长文切成三种标签——Label 0 代表人类写作,Label 1 代表纯 AI,Label 2 则是疑似 AI。这份初稿的中间八百多字勉强守住 0.4889(Label 0),开头五百多字标成 0.5471(Label 2),结尾五百多字冲上了 0.7433(Label 2)。
我一开始又猜错了。看着末尾的 0.7433,我疑心最后两段总结写得太像说教升华;回头看开头的 0.5471,又觉得前面的自问自答过渡太刻意。
不想再瞎蒙,我又补了三十多组二阶消融,先把结尾那五个自然段(图 3 里的 Q0 到 Q4,单独测是 0.8345)拆开重组,再对并列条目逐项加减。
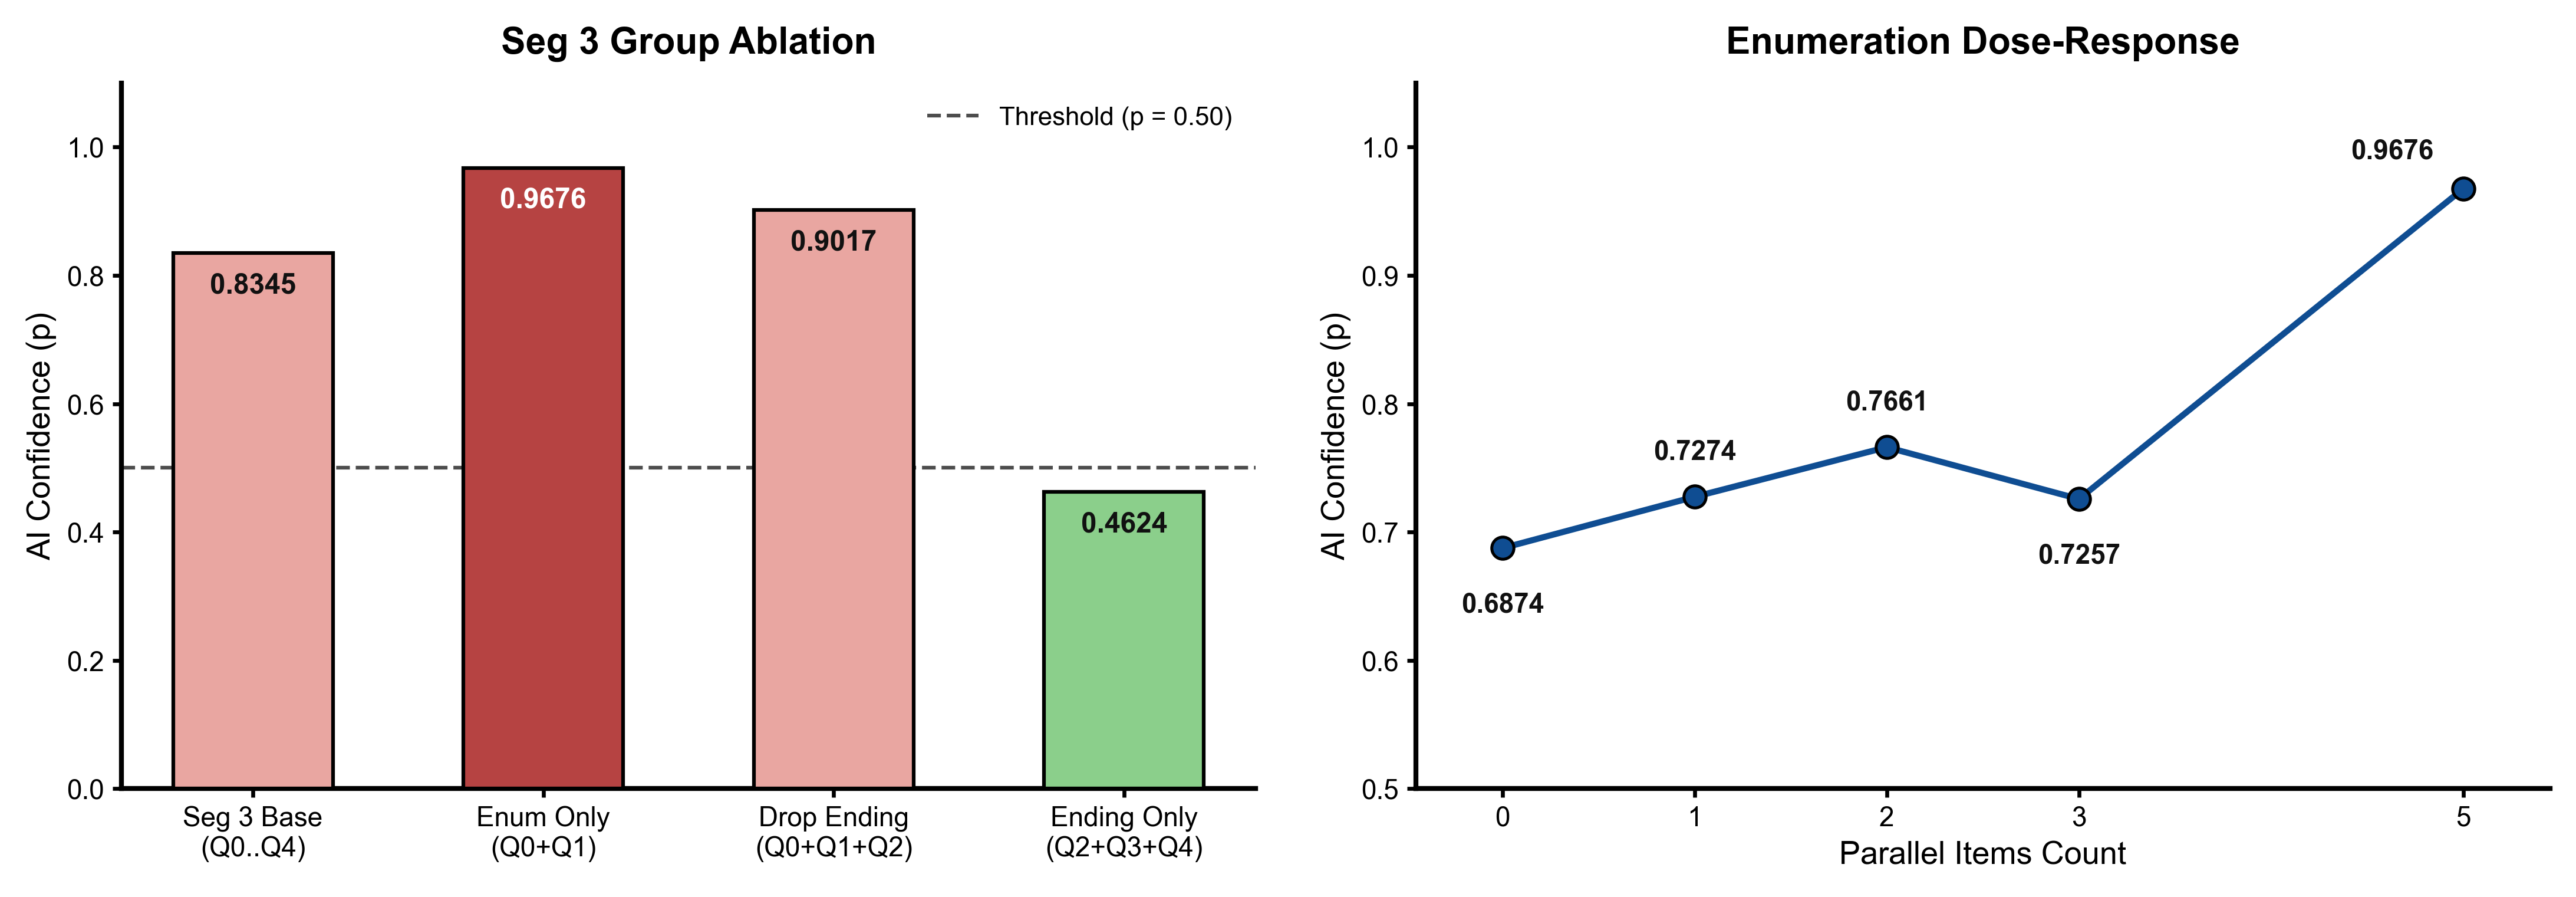
图 3 左边直接否定了我的猜想。删掉结尾两段只留前三段,分数反倒涨到 0.9017;抽掉前两段只测最后三段结尾,分数只有 0.4624,稳稳在人类区间。真正拉爆末尾的,是单独测就能飙到 0.9676 的前两段 Q0 和 Q1——那里用了“第一次……、第二次……”分步报账,冒号后面还连着排了五个一模一样的改词短句。
右边的剂量-反应曲线讲明了原因。就像药理实验一点点加剂量,我从零条开始往句子里逐条加并列项。只留“第一次/第二次”的架子时,分数已经是 0.6874;加进一到三条,分数只在 0.72 到 0.77 之间晃动,零散举一两个例子其实无伤大雅。可一旦把五个同构短句铺满,分数一下跳到 0.9676:单个词往往没多大伤害,连续堆叠的模板排比才会触发非线性跃升。
局部窗口里的人类护盾
末尾找出了原因,开头 0.5471 和中段引文又是怎么回事?我把前七段逐段拿掉重测,结果又一次猜错:删掉自问自答短段后,开头这个七段切片的 AI 率反而从 0.5572 涨到了 0.5961 到 0.6339。抽掉带着“在脑门上贴了张机器生成的标签”这句大白话的第二段,整篇文章的总分直接从 0.3546 冲上 0.9999。这些大白话和生活比喻从来不算多余的废话,它们一直在替全文当人类护盾。
我又对中段做了全文留一排查,把四个修改阶段画成一张切片地图。
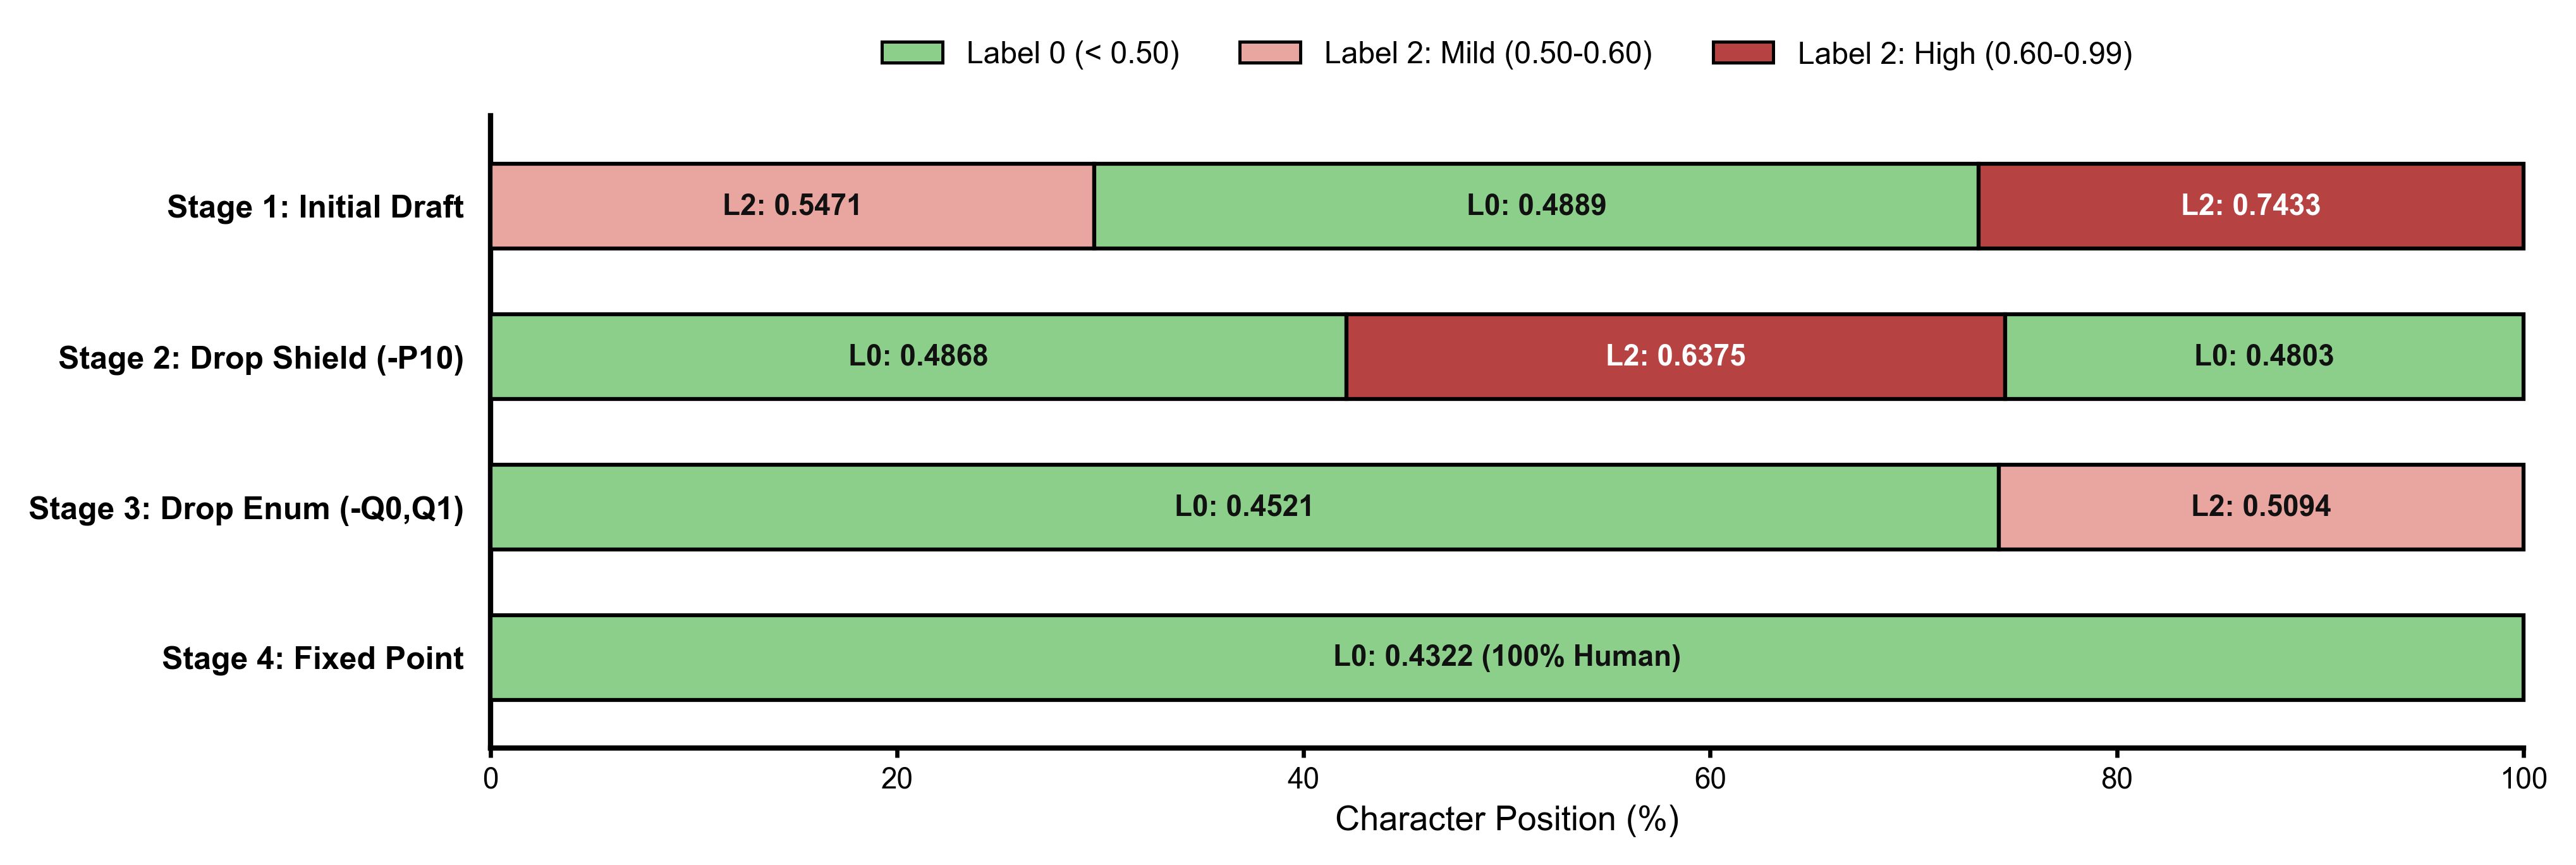
顺着图 4 从上往下看,第一行是初稿的三段切片。中段原本照抄了样本 A 最致命的两句原话,全靠前面“悠儿和佑二”那段大白话在局部窗口里对冲,才勉强压在 0.4889 底下。第二行把那段护盾抽掉后,中段当场跳到 0.6375。第三行拿掉开头短段和末尾五连排比、再截短引文,前面大片很快合成了安全区(0.4521),只剩结尾微微露头(0.5094)。
为什么朱雀返回的相邻片段标签永远严格交替,从不会出现挨着的两段同是 Label 2?因为朱雀切分长文从来不按固定字数硬砍,它的做法是拿一个四百到六百字左右的滑动窗口从头扫到尾,先给每个窗口独立打分贴标签,再把挨在一起、标签也相同的窗口合并成一整块(也就是所谓的游程合并)。
这也说明,长文能不能过检,光看全篇平均分靠不住,还得盯紧每一个五百字局部窗口里的信噪比。高危引文和排比句在局部窗口里扎了堆、护盾又不够厚,那一片就会单独翻红。这和 Joffoo 在翻译小说时遇到的麻烦属于同一个结构:如果只在当前几百字的分片里匹配人名,平假名和片假名不会同时出现,匹配就会失灵;换成整本书的视野就不会。局部切片会改写原本的统计平衡。
搞清楚这些以后,真正动刀改稿的地方其实没几处。开头那二十六个字的报幕短句直接拿掉,中段里引用的样本 A 原话用省略号截短,顺便拆散对称句架子。结尾那五条报账也全部删了,改写这次写稿自己踩出 0.7433 的过程。改好的 1699 字文稿送回朱雀复测,全篇合并成一整段 [0, 1699],总分停在 0.4322,拿到了 100% 的 Label 0。
跑完五十多组测试攒下的改稿实话
如果平时自己改 AI 辅助写的稿子想少走点弯路,从上面这五十多组测试数据里能直接拿走四条实话。
第一条是真不用跟四字专业词和标点符号较劲。很多人改稿子上来就先删“过度优化”、“局部匹配失效”这种术语,或者去抠引号和顿号。其实改标点只让分数从 0.9961 挪到 0.9940,把“过度优化”那句话单独塞进人类底本里也才 0.0120。该用的专业词留着就行,没必要把内行话全改成外行话。
第二条是先拆一头一尾的对称转折架子,再去松单字虚词。段首的让步转折和段尾的价值对比占了将近一半的嫌疑分,直接拆成按先后顺序说的大白话最好。接着把句子里扎堆的“常、虽、却、极、与、为、向”拆成双字口语,光改这几处小词,底层的机器得分就能掉下去将近八成。
遇到上千字的长文,还得算一下五百字窗口的局部账:同一个地方别连着排四五条同构的并列句,举一两个例子就收手;每隔几百字留两句带具体人名或者小翻车细节的大白话,像前面救了场的“悠儿和佑二”。
回过头看,我从一开始猜“过度优化”,到写长文时怀疑开头和结尾,前前后后猜错好几回。跟着跑完二十二组一阶测试、三十多组二阶测试,才勉强找回这个稳妥的终点。改稿子的时候凭直觉挑词往往抓不准重点,拿控制变量先把检测器测一遍,起码能少走几步弯路。
