之前说过,用 Skill 战胜不了 AI 检测器,本质是用规则战胜不了神经网络。
但也有人说过,可以接入朱雀的 API,做一个反馈环路,让 Agent 自己决定怎么修改语句,你只需要指定目标,之后就看模型自己的智慧了。
接入朱雀
大家可能对下面这个页面更熟悉一些,登录账号之后每天有 20 次的免费检测机会。检测之后可以看到哪部分有 AI 创作嫌疑,哪部分人类创作特征是显著的。
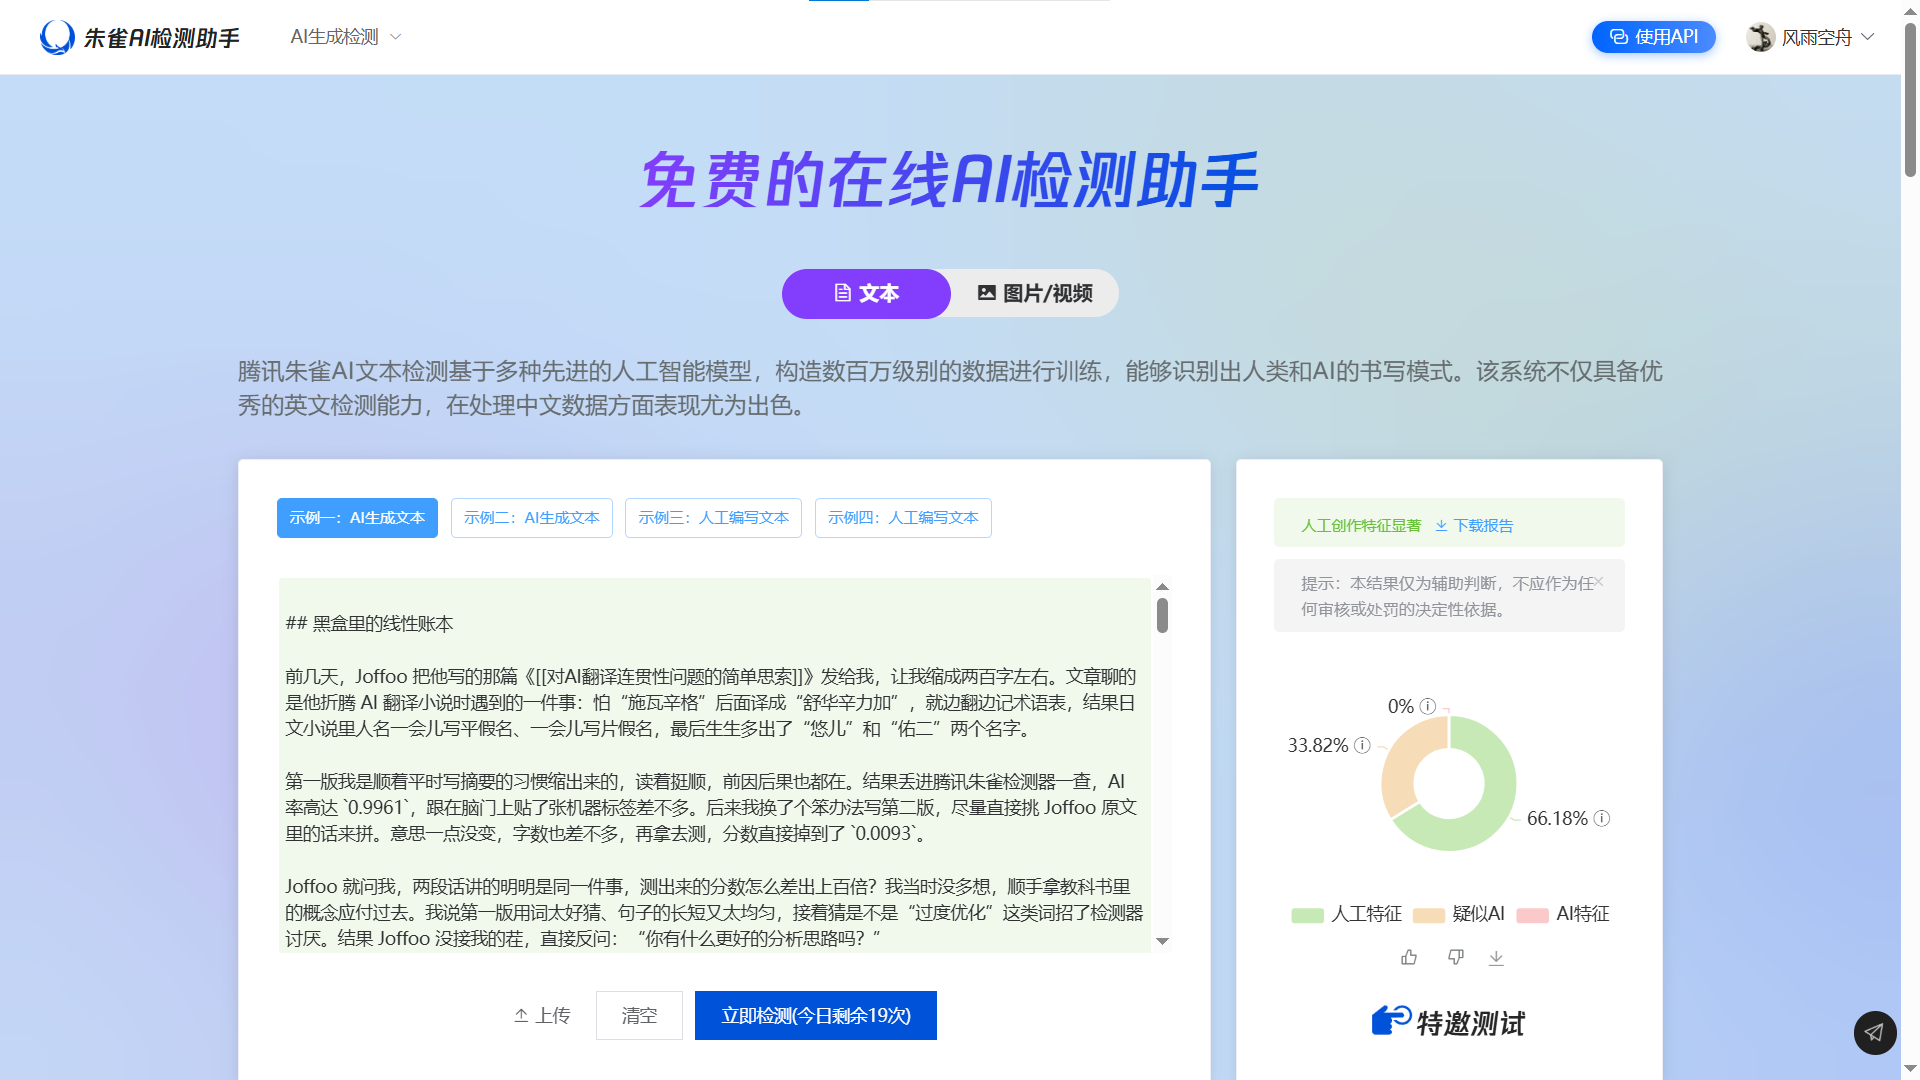
其实你可以去 EdgeOne 控制台 实名申请一个 API key,之后把教程丢给 Agent 让它自己配置一个检测 Skill,如果有相关场景可以让它调用朱雀大模型自己检测。
之前的两篇文章,我测过翻译、回译对 AI 率的影响(谁解 AI 味:为什么 AI 写的东西这么难读?AI 翻译会不会影响 AI 率?),测过市面上两款 Skill 的效果,还开发了自己的遮味工作流(去 AI 味之我见:让 Agent 学会“因声求气”),都是用朱雀 API 做的检测。
经常在网上刷到 Lauren Tan(@poteto)说 AI 编程中验证是相当重要的一环。让 Agent 接入朱雀 API,其实就是把写作这个流程加上了验证反馈。
但如果只是做成一个文章生产流水线,对我来说还没有那么有意思,我倒是喜欢让 Agent Cosplay 研究者,让它去研究朱雀这个不可解的黑盒,看一下能有什么局部的理解。
镜像实验
在公众号发过文章之后,会有一个自动转成贴图的功能,在我理解,就是用更轻量的形式,给自己的内容做广告。图片部分就是一个标题转成的封面,之后是文章中的插图,配的短文一看就是 AI 写的。
于是我自己用 AI 重写了一版,测出来 AI 率很高 0.9961。
既然我已经有一篇手写的长文,直接尽量使用原句让 AI 重写了一版,效果显著,AI 率直接掉到 0.0093。
| 句号索引 | 所属段落 | 样本 A(p = 0.9961) |
样本 B(p = 0.0093) |
|---|---|---|---|
S0 |
P1 |
AI 翻译长篇小说常前后不一,前面是“施瓦辛格”,后面变成“舒华辛力加”。 | AI 翻译长篇文本时容易前后不一致,前面是施瓦辛格,后面是舒华辛力加。 |
S1 |
P1 |
提前提取全书术语表虽能解决,却极耗 token 与人工筛选的精力。 | 我对提前跑一遍术语表感到厌烦,于是先切片,让 AI 先翻译,再把新词写入术语表,并检索后文,没再出现就不存。 |
S2 |
P2 |
我改用“边翻译边累积”的动态术语表,并检索后文剔除一次性词汇。 | 为了再省点 token,我想只把当前分片出现的术语放进提示词。 |
S3 |
P2 |
后来为进一步省钱,我尝试只向提示词注入当前分片出现的术语,结果栽了跟头:同一人名混用平假名与片假名,局部匹配失效,生生译出了“悠儿”和“佑二”两个角色。 | 结果遇到平假名和片假名:术语表里存了平假名,分片里却只出现片假名,匹配不上,于是生生多出两个人名,一个“悠儿”,一个“佑二”。 |
S4 |
P3 |
我最终放弃了过度优化。 | 我选择了放弃。 |
S5 |
P3 |
比起省下几块钱的 token,译本出现硬伤、消耗自己有限的注意力,才是更不能接受的代价。 | 我的注意力是有限的,token 成本不过降低几块,但译本出现硬伤,哪怕只是有这种风险,对我来说也是不能接受的。 |
让我自己分析的话,人(我自己)的写法比较随意。AI 会写“前面是……后面变成……”,而我只是写“前面是……后面是……”,没有非要换个说法的强迫症属性。
我之前可能不是这样写文章的,但现在确实没有“语不惊人死不休”的想法,写完就算。
AI 的分析是:AI 写东西常常总结,而我保留了口语习惯(流水账);AI 的句式更为工整,而我不是;AI 写得更抽象客观,而我有具象体感。
自己分析或者让 AI 分析,都差不多,陈词滥调。既然我们有了反馈,就可以直接让 AI 自己去做“研究”。
这里的 /better 其实是来自 Felix Rieseberg 写的一篇文章,把文章里提升 Agent 回答深度的提示词封装成了技能,写下来大概是这样的:
我希望你把这项任务做得更深入,而不是把任务范围扩大。在重写我的要求之前,请先回答四个问题:
这个领域最顶尖的专业人士,会做哪些我目前没有要求你做的事情?
相比那些已经整理、加工过的信息,他们会从哪些最原始的材料入手?
他们会使用哪些具体的方法和工具?
除了你和我自己的判断,还有什么外部证据能够证明结果是正确的?然后,根据这些答案,重新编写我的提示词,让它准确地要求完成上述工作。
这篇文章的标题是“如何更有野心”,我现在的心明显野了。
我常常无脑用这段深度提示词,封装成 /better 之后用起来就更加无脑,把我自己的“深度”直接转交给了 AI,但好处是你能学到一些之前全然无知的东西。
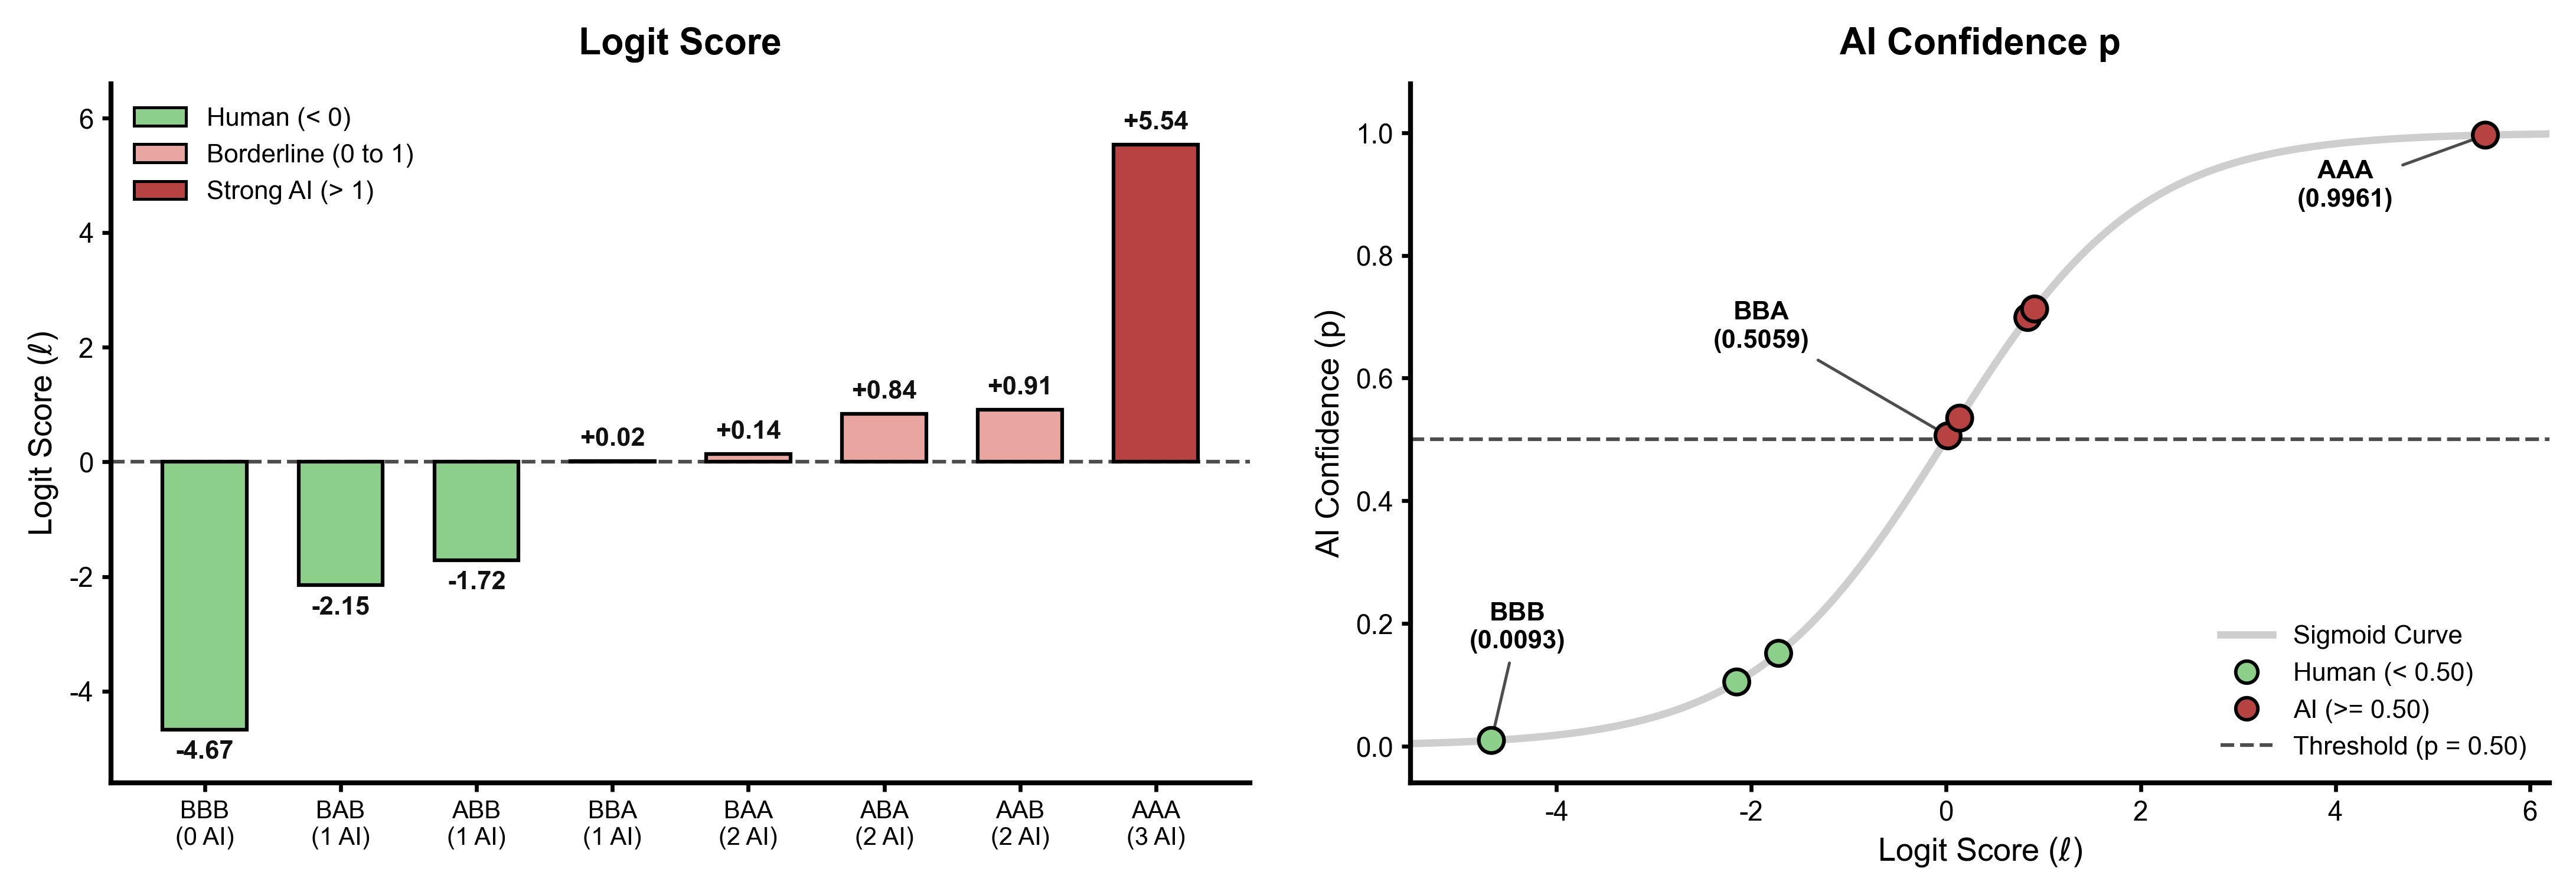
AI 把之前的段落拆分成三部分 (P1, P2, P3),在 AI 生成的样本 A 和我自己语言拼凑的样本 B 之间做全排列组合,测试输出的置信度 $p$ 和对数几率 $\ell$:
段落组合 (P1, P2, P3) |
AI 段落数 | 朱雀置信度 $p$ | 对数几率 $\ell = \ln\frac{p}{1-p}$ | 相对全人类基线 (BBB) 的 $\Delta \ell$ |
判定分类 |
|---|---|---|---|---|---|
(B, B, B) |
0 | 0.0093 |
-4.67 |
0.00 |
人类 (Label 0) |
(B, A, B) |
1 | 0.1046 |
-2.15 |
+2.52 |
人类 (Label 0) |
(A, B, B) |
1 | 0.1513 |
-1.72 |
+2.95 |
人类 (Label 0) |
(B, B, A) |
1 | 0.5059 |
+0.02 |
+4.69 |
AI (Label 1) |
(B, A, A) |
2 | 0.5347 |
+0.14 |
+4.81 |
AI (Label 1) |
(A, B, A) |
2 | 0.6988 |
+0.84 |
+5.51 |
AI (Label 1) |
(A, A, B) |
2 | 0.7127 |
+0.91 |
+5.58 |
AI (Label 1) |
(A, A, A) |
3 | 0.9961 |
+5.54 |
+10.21 |
AI (Label 1) |
可以看出第三段 P3 的影响最为显著,当仅保留 1 个 AI 段落时,(B, A, B) 与 (A, B, B) 均停留在 0.10 至 0.15 的安全区;唯独 (B, B, A) 仅凭第 3 段短短 47 个字,就产生了 +4.69 的 Logit 增量,单独将整篇人类文本推过 0.50 阈值线(0.5059)。
为什么要这样算?其实这个是二分类 Softmax 的反推公式。
朱雀后台原本是按 Label 0 / 1 / 2 三分类算 Softmax 的,但它只暴露了一个汇总的置信度 $p$(softmax_confidence),没给三类各自的原始概率明细。所以我们用二分类的逆运算做近似反推。
另一方面,还原成线性可以更为直观地理解每一段的作用,而不会被 Sigmoid 曲线的缓急所蒙蔽。
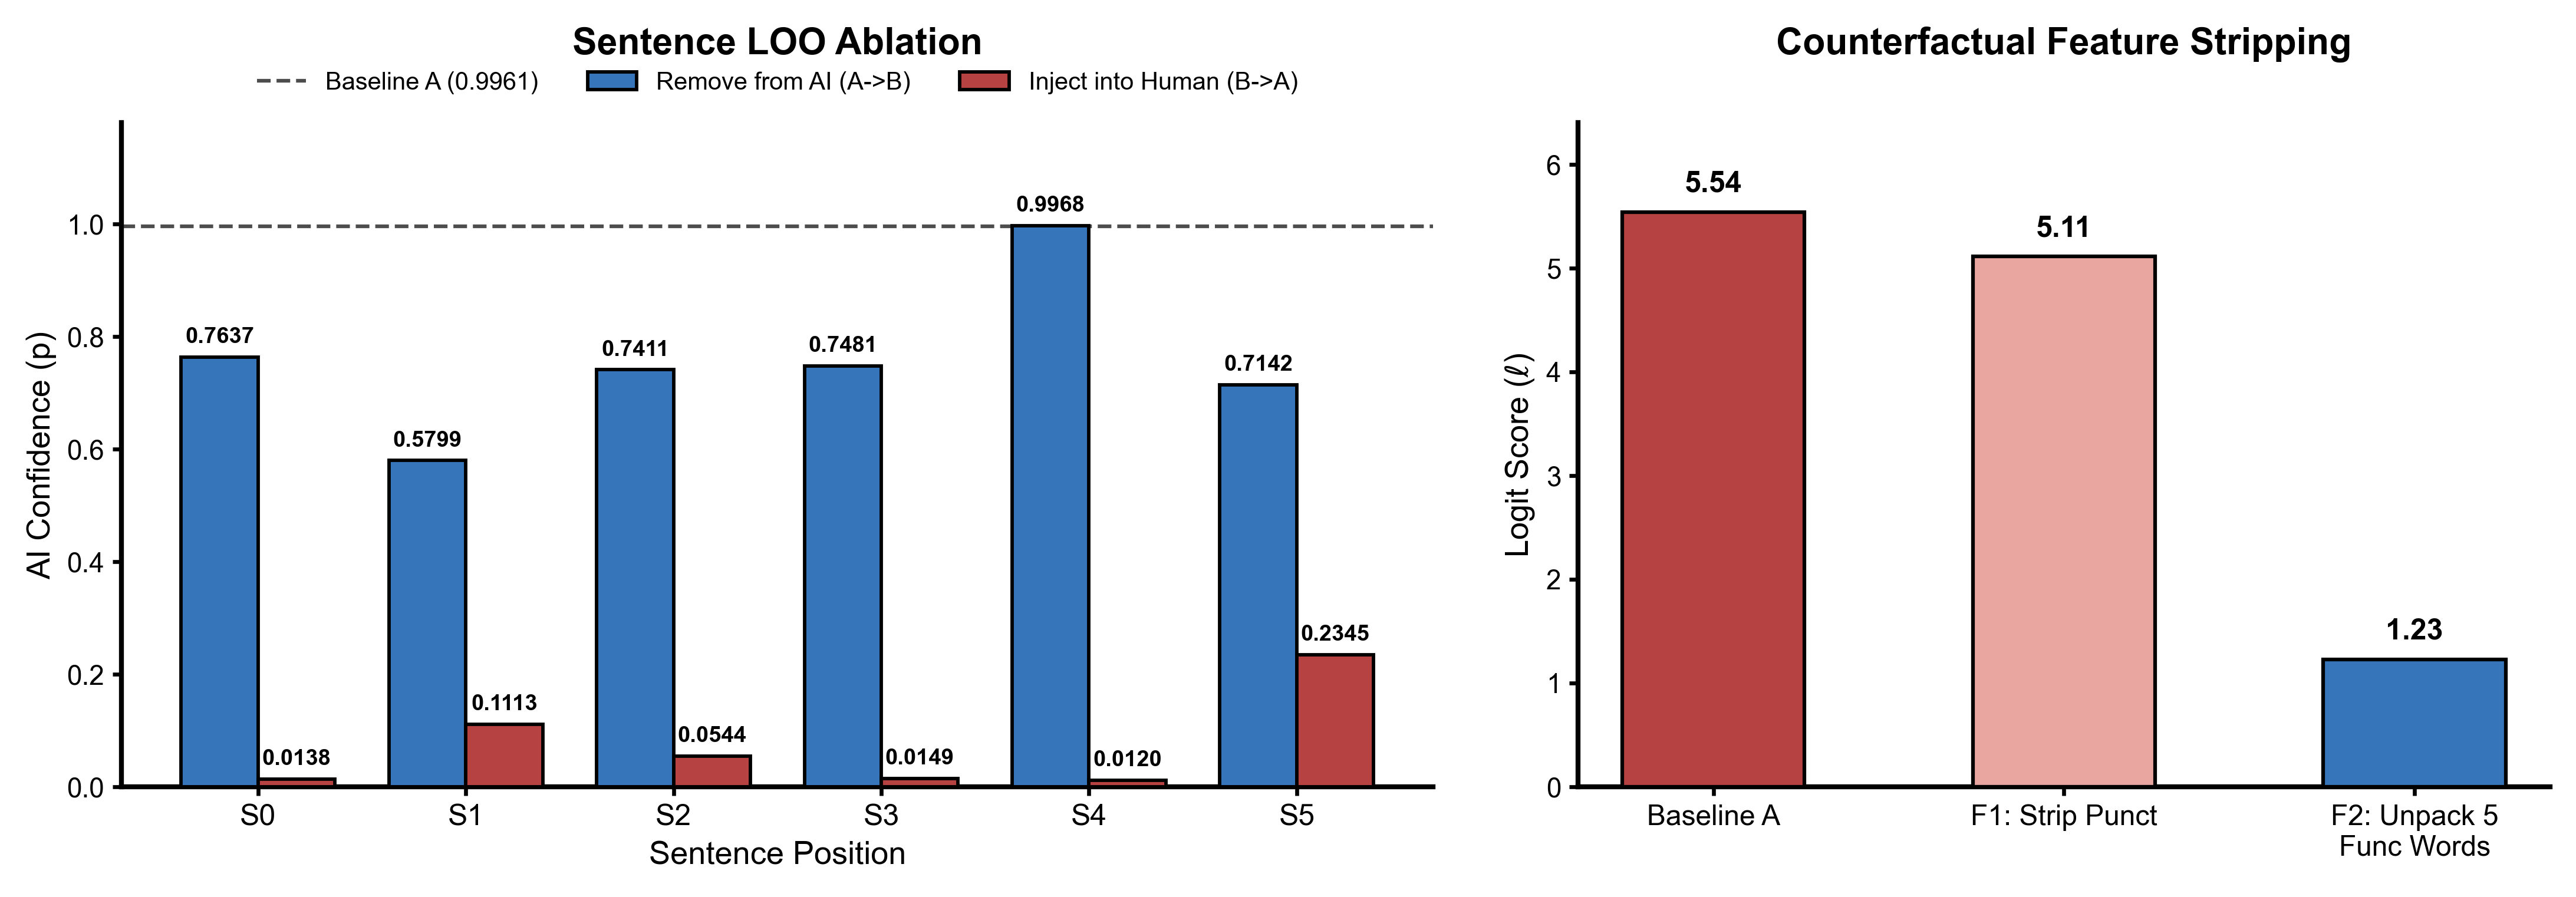
AI 还计算了单独某句话的置信度影响,影响最大的是 S1 和 S5,正是压缩内容最为明显的两句话。
此外,还计算了标点的影响和虚词的影响,可以看出标点影响较小,而虚词影响极大,这些虚词分别是:
常→时容易(AI 翻译长篇小说常前后不一→AI 翻译长篇小说时容易前后不一致)虽……却极……与→虽然……但很……和(虽能解决,却极耗 token 与人工筛选的精力→虽然能解决,但很耗 token 和人工筛选的精力)为进一步→为了再(后来为进一步省钱→后来为了再省钱)只向……注入→只往……里放(只向提示词注入当前分片出现的术语→只往提示词里放当前分片出现的术语)与→和(平假名与片假名→平假名和片假名)
自指引擎
之后我让 Agent 把前面的内容写成了一份报告,再把报告写成文章,并且检测文章的 AI 率,测出来是 0.3546。
对 AI 率较高的段落,Agent 继续自行研究。
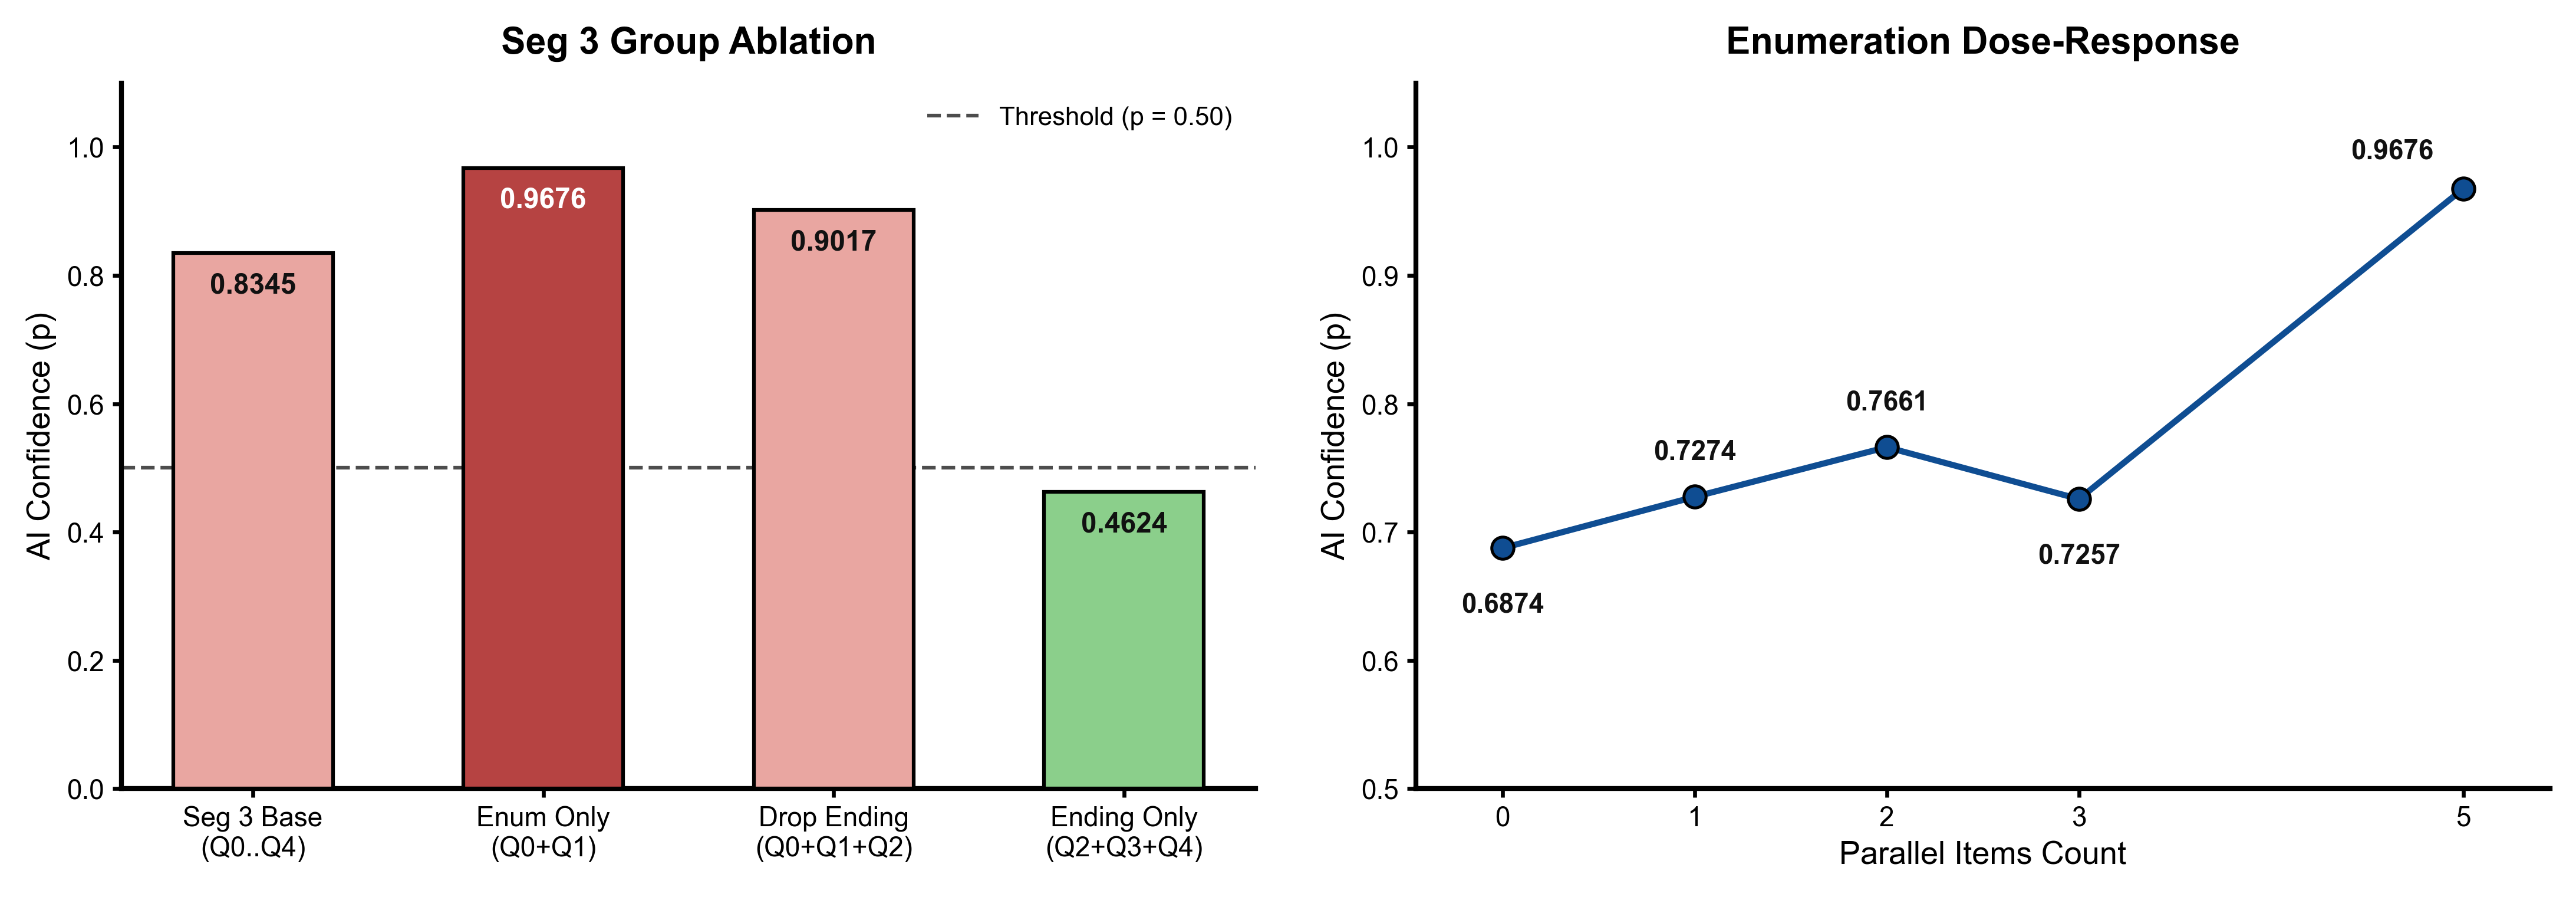
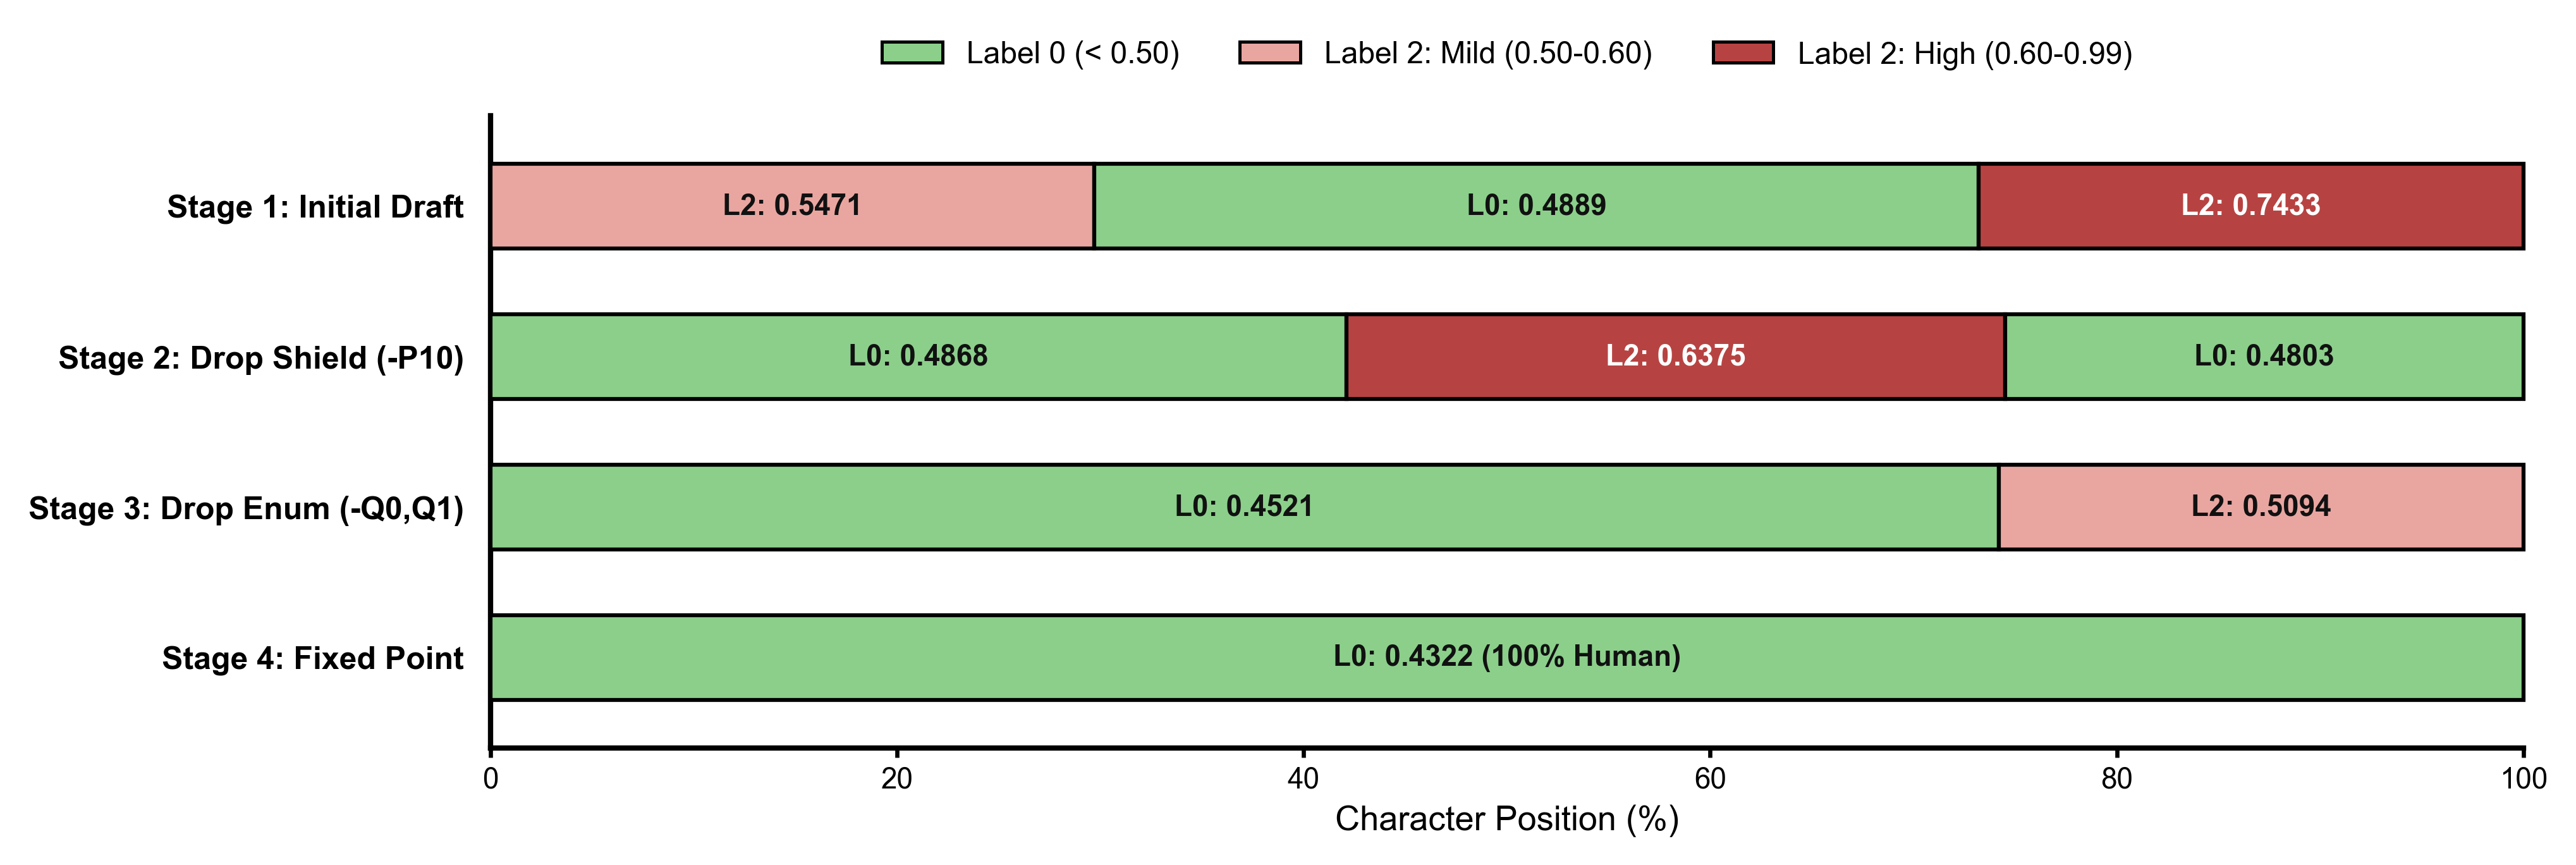
我已经没什么参与的兴趣,于是让 Agent 调用“蜂群” /Swarm 写了一篇文章同步发表,作为另一种并置的镜像 AI 检测 AI 检测(阴本):一次关于 AI 检测器的自指实验记录。
朱雀测不出来,但这篇 AI 味还是相当重,比如:“如果平时自己改 AI 辅助写的稿子想少走点弯路,从上面这五十多组测试数据里能直接拿走四条实话。”
什么叫“直接拿走四条实话”,什么叫“拿走实话”,什么又叫“四条实话”?
但毕竟是一份心意,这四条是说:
- 术语和标点影响不算大;
- “让步转折”之类的写法拆成先后顺序,不要单字虚词;
- 写具体细节;
- 要降低检测率,就控制变量用检测器多次测试,不靠模型直觉。
划重点
- 你可以让 Agent 接入朱雀检测模型的 API,让 Agent 自行降低文字的 AI 率,但这种方式也不能有效减轻 AI 味。
- 探索黑盒系统时,可以学习 Agent 的思路,把复杂问题拆解成一系列小的对照实验,逐点击破。
- 使用 Agent 时善用技能、提示词和自带插件,比如文中提到的
/better和/Swarm。
第四点,前面三点都是戏仿得到 APP 的课程结尾。我不认为这篇文章有任何重点,只是一次记录,并且我的兴趣(甚至是耐心)已经随着写作而消耗殆尽。
说点有意思的。
我之前还做过一次实验,脏话能不能影响朱雀的检测结果。最后发现,如果只是间歇性加脏话,或者是连续脏话宣泄都不行,只有纯粹骂街才可以,那种没有任何叙述、没有任何诉求的“纯粹”。
朱雀说,softmax_confidence 0.2569,Label 0,纯人类创作。
这算是 AI 检测对人的一种刻板印象吧。
