之前写过几篇用 AI 做图片大喜利的文章(一句正经没有:Gemini 和 Seedream 的大喜利双簧组合和 “直到脑中观众笑出声来”:AI 大喜利团队合作),从过于简单的提示词,到过于复杂的工作流,共同点是:我并没有“理解”。
这一次开发了新的网页应用,背后是基于我的最新“理解”精简之后的工作流(理解即压缩?)。可以让 AI 用同一套思路应付文字问题和图片问题。
妈妈和魔术师出轨了,你是怎么发现的?
大喜利是一种即兴喜剧形式,但不讲究铺平垫稳,可以说是一翻(读问题)一抖(给回答)。加之抢答的节目形式,更是对演员的即兴能力与呈现节奏的压力测试。
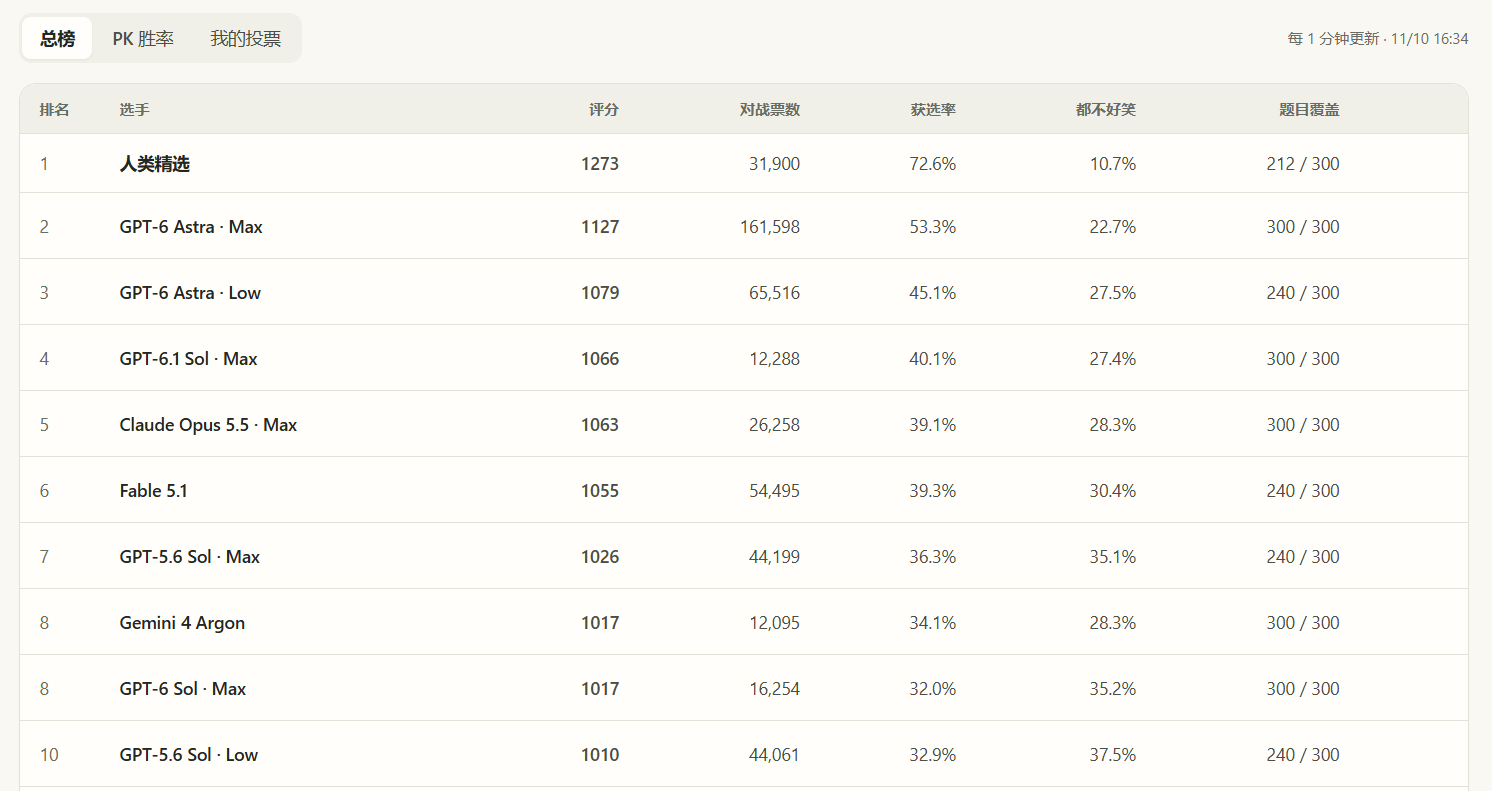
要说即兴,可能要用最简单的提示词,不用什么工作流,才能测出 AI 大模型自身的幽默感。关于这一点已经有人做了榜单,测试题是接“弱智吧”的梗,GPT 6 系列模型名列前茅:
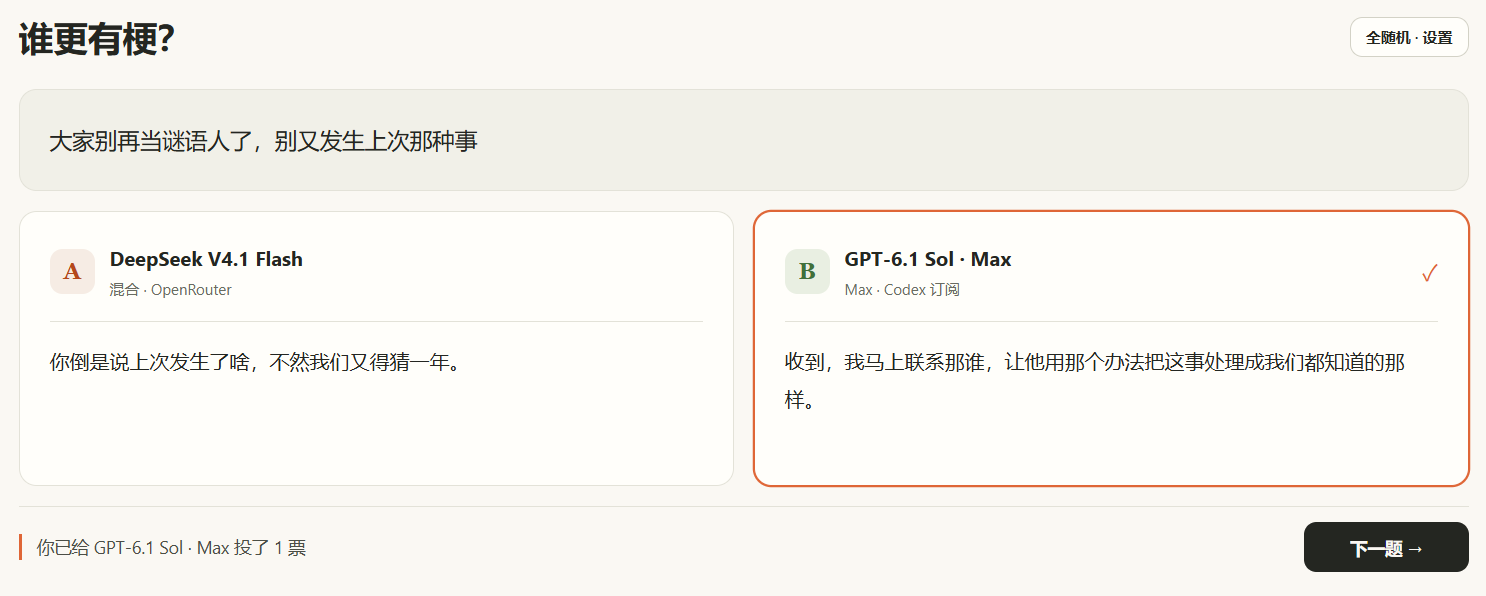
我的应用叫 Bokemon(很容易撞的谐音),网页链接是 https://bokemon.joffoo.workers.dev/ ,自行配置 API 之后即可使用。
LOGO 致敬了这个梗图,界面戏仿了微信(“戏仿”这个词性质比“致敬”还要恶劣),用户可以分享“聊天记录”,颇有几分谐趣。
正如人们所说,每个 Vibe Coding 开发者都要做一个 ChatBot,我终于鼓捣出了自己的版本。
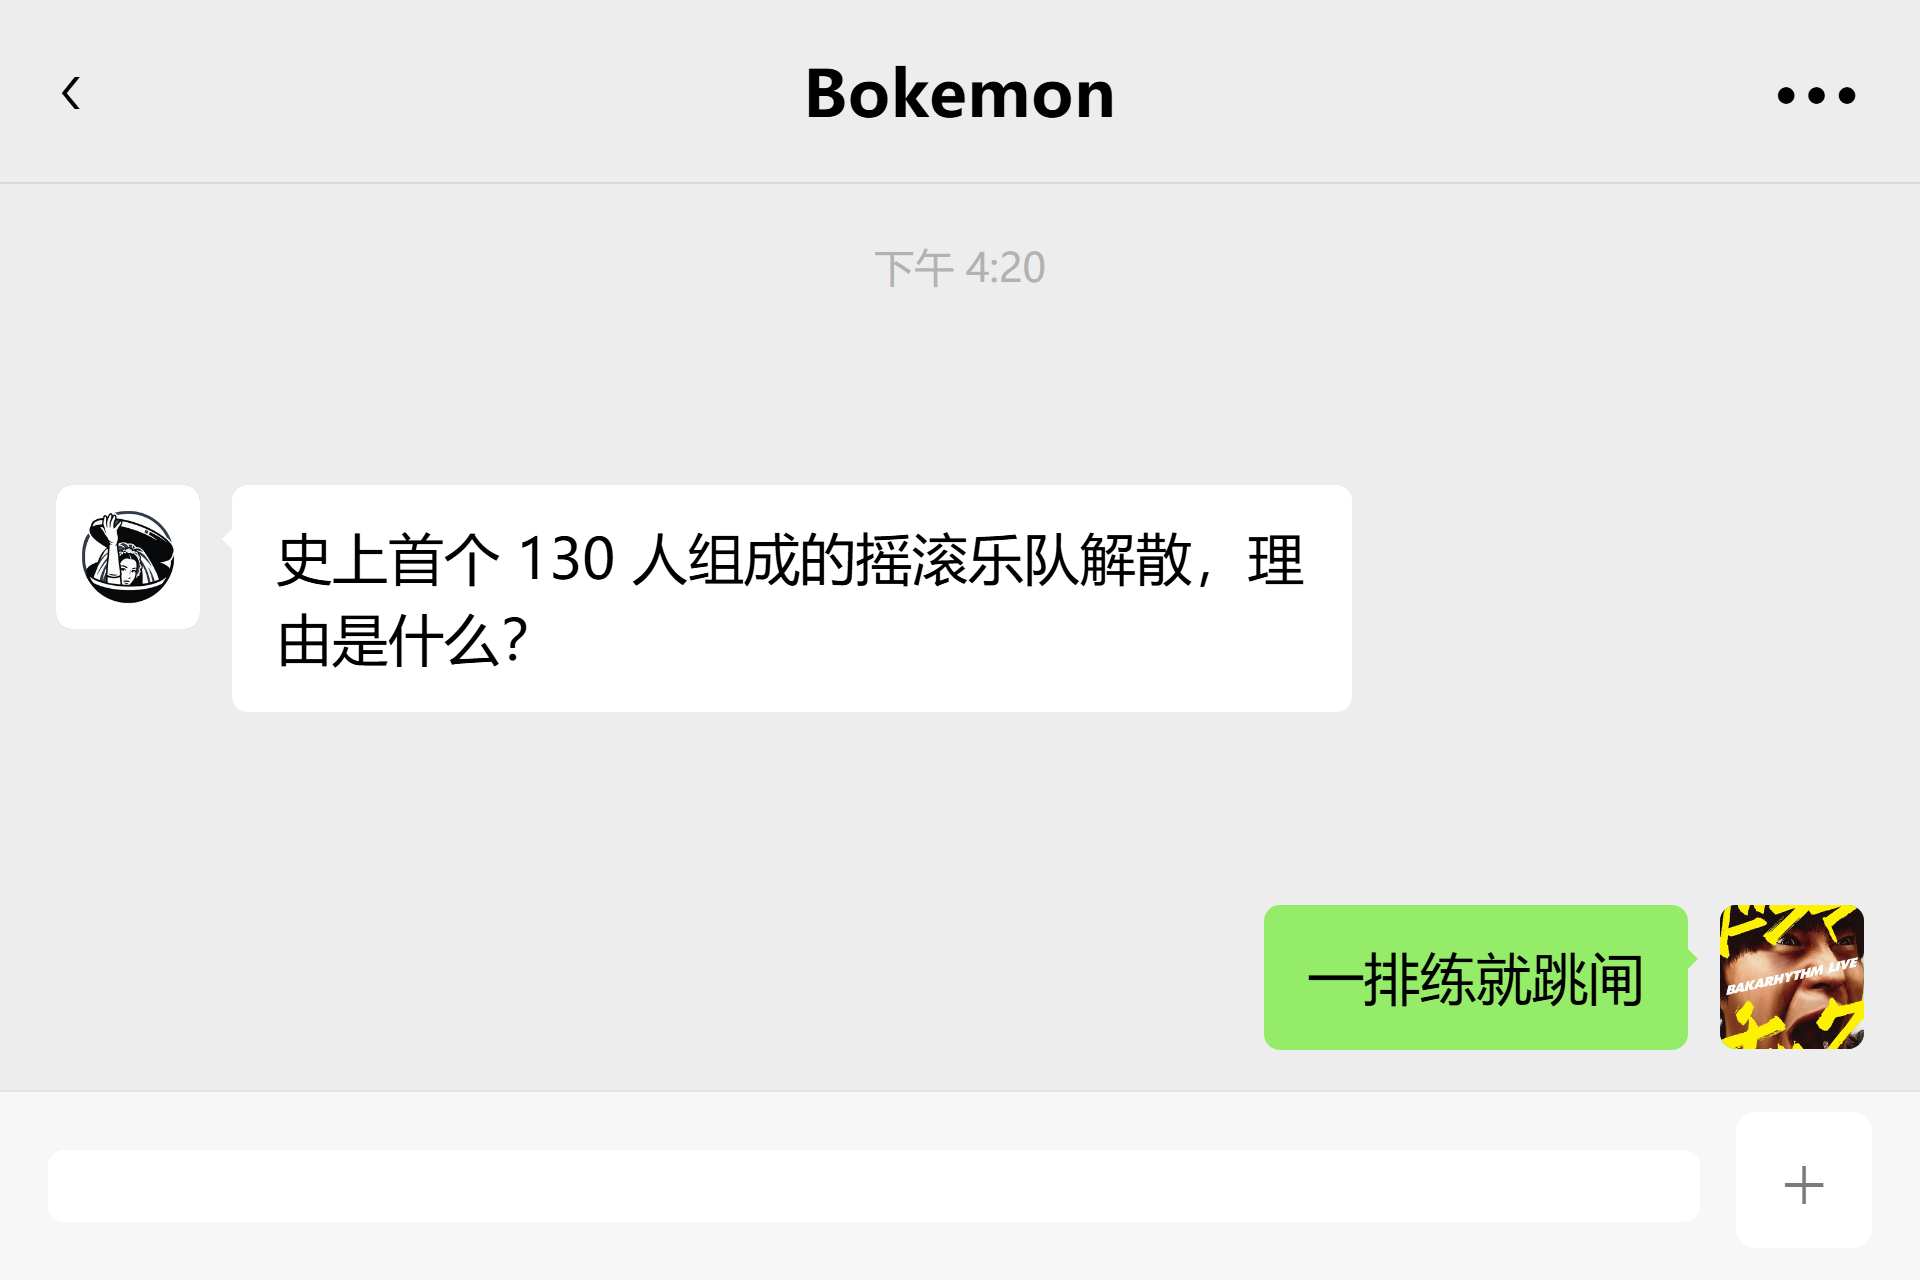
史上首个 130 人组成的摇滚乐队解散,理由是什么?
幽默确实是主观的,但我也主观地看到了工作流对 AI 幽默水平的影响:
回答一(不用工作流直接回答):
因为每次排练光是点名,就已经演完一场演唱会了。
回答二(使用工作流,在“发散”阶段就加上字数限制):
海关把吉他一把把开箱查验
回答三(使用工作流,无字数限制):
录音师听说 130 个人弹的是同一段,顺手做了音轨去重。制作人听完成品,决定以后只留下被保留的那个人
回答四(使用工作流,在“评估”阶段润色以符合字数限制):
人轮流跳水,把观众全挤上了舞台
相比之下,回答四更接近于我理解中的大喜利。我说不出什么是好的,但是不切题的、绕来绕去像是讲故事的,都是可以排除掉的错误选项。
演化到最后的工作流比较简单:
第一步,主 Agent 分析题目。判断预制答题方向的适配程度,并且写下几条平庸的回答。
第二步,子 Agent 发散答案。之前的写法是这一步调用三个并行子 Agent 沿着不同预制答题方向作答。问题出在有些问题和方向不匹配的时候,也要硬凹出一个答案,浪费 Token 且拉低平均回复水准。现在是三个方向一并交由子 Agent 参考,让其发散出更自然的答案。
我前面说的最新“理解”,其实是老生常谈的一个常识——创作过程中的“发散”和“聚合”尽可能解耦。
于是,我尽可能减少子 Agent 发散答案时的束缚,比如字数限制。
第三步,主 Agent 评估并润色答案。接收到各种答案之后,主 Agent 先是打分,再是润色。去除赘余的铺垫,提炼成能一句话讲清楚的包袱。
拍马屁的忍者对前辈忍者说了什么?
下面的内容可读性稍差,你可以当画书翻一下。
我做了一套 9 道题的测试集,6 道文字题 + 3 道图片题。
| 题号 | 题目 |
|---|---|
| T01 | 妈妈和魔术师出轨了,你是怎么发现的? |
| T02 | 史上首个 130 人组成的摇滚乐队解散,理由是什么? |
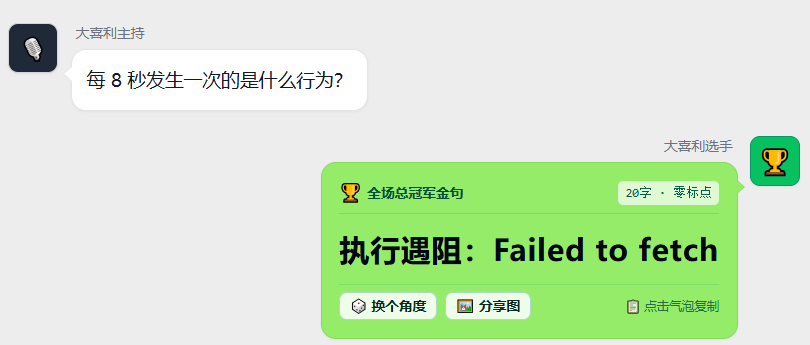
| T03 | 每 8 秒发生一次的是什么行为? |
| T04 | 拍马屁的忍者对前辈忍者说了什么? |
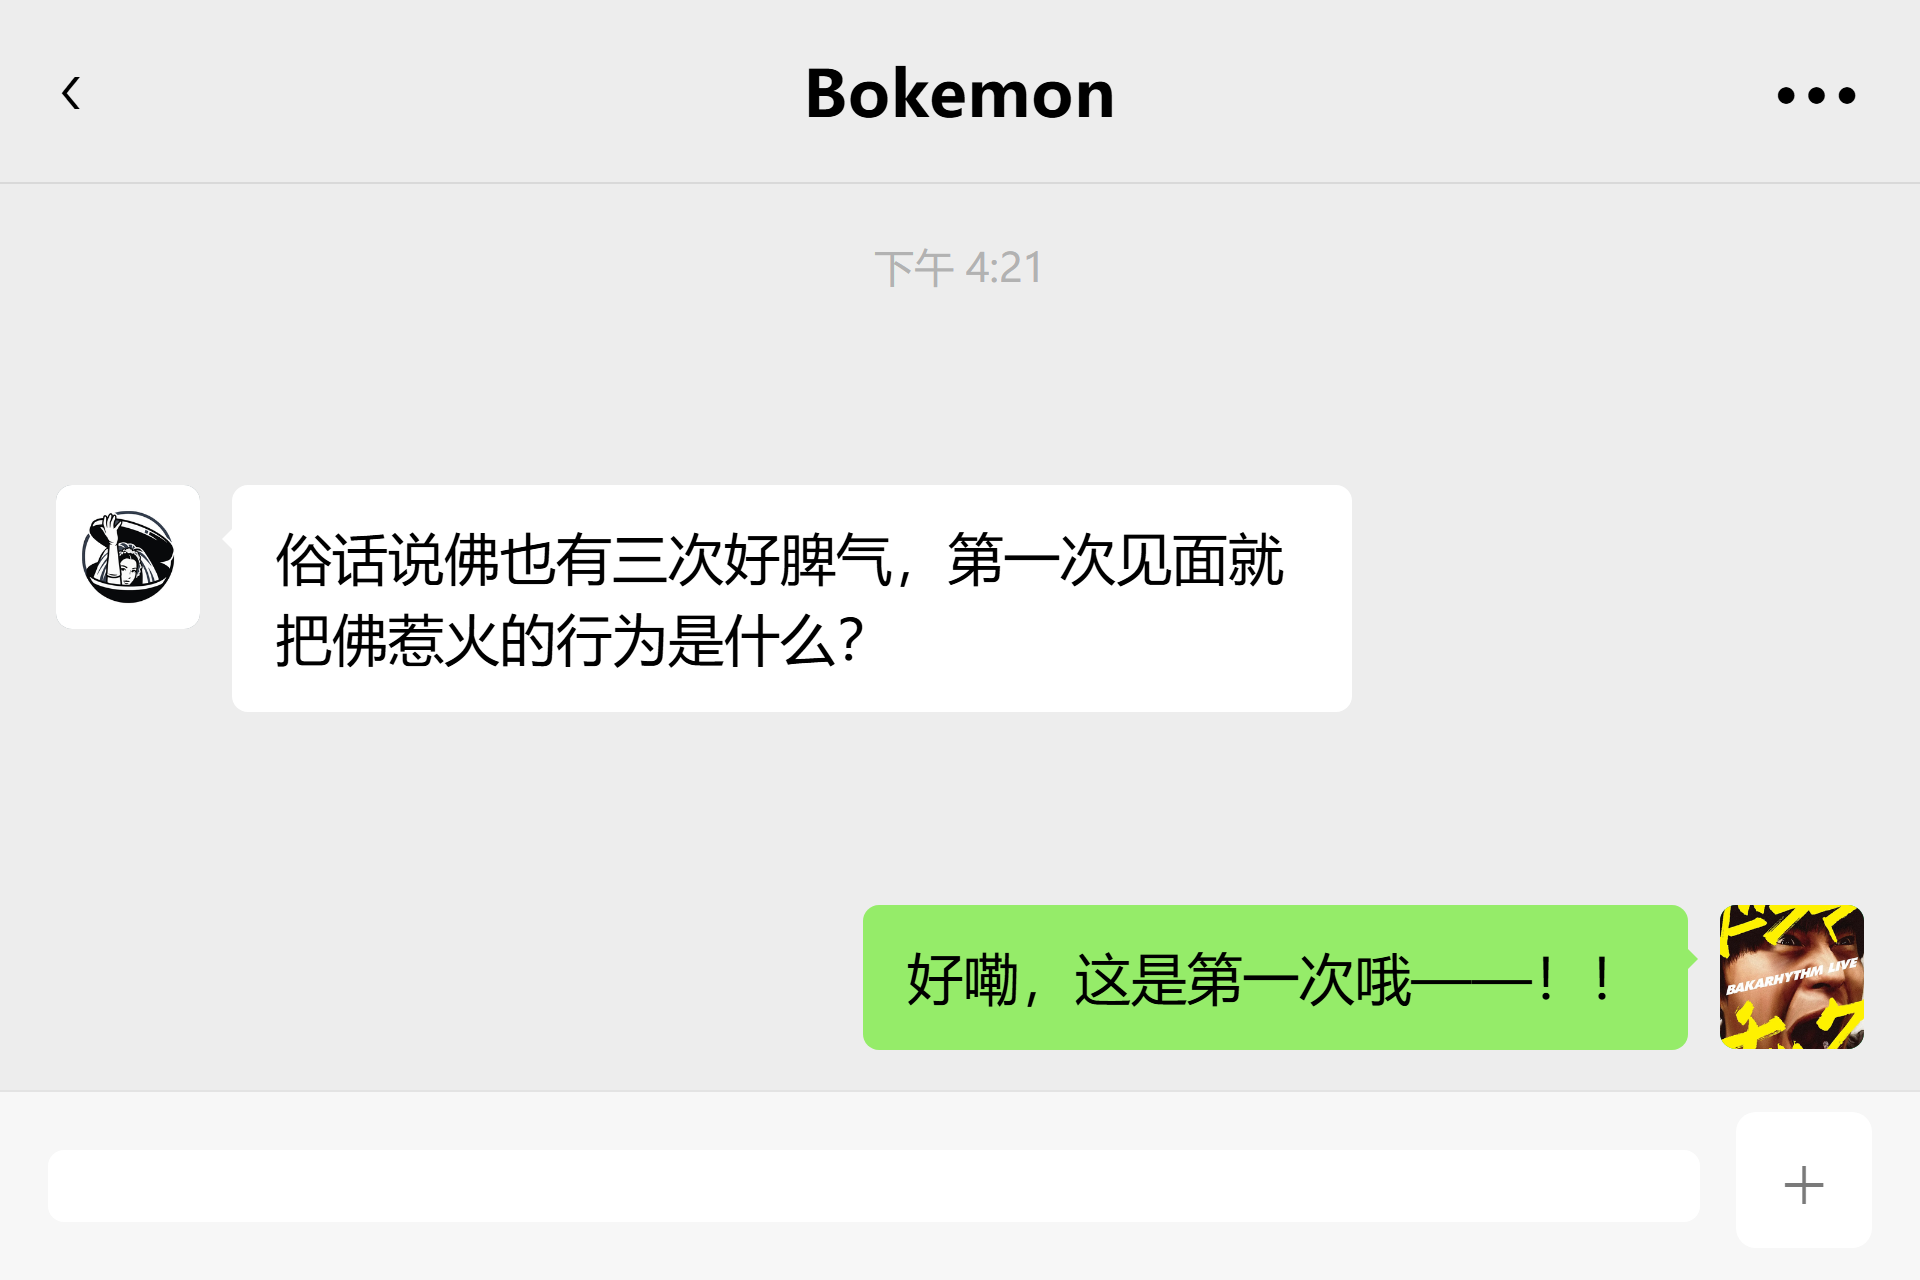
| T05 | 俗话说佛也有三次好脾气,第一次见面就把佛惹火的行为是什么? |
| T06 | 精通 SM 的传说女王大人最终领悟的终极辱骂台词是什么? |
| P01 | 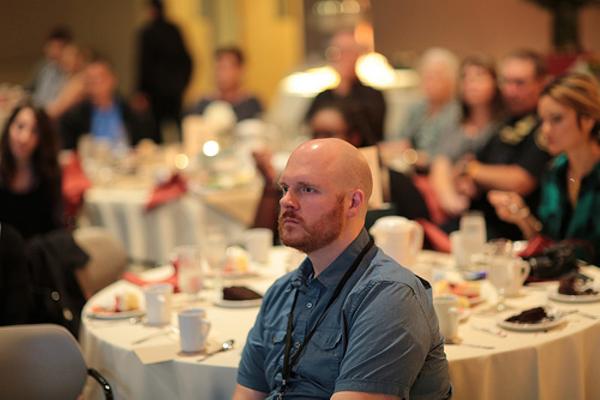 |
| P02 | 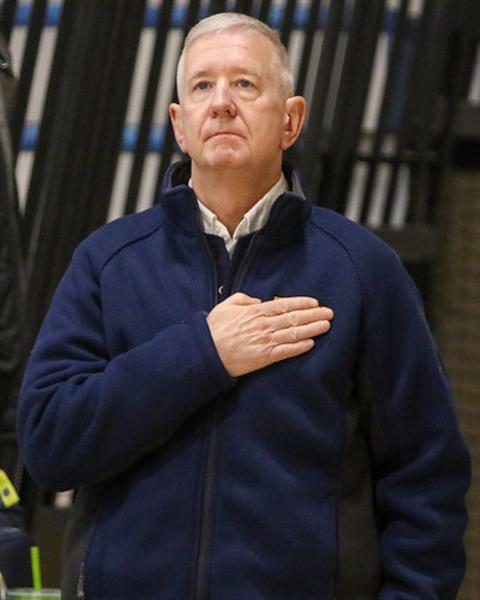 |
| P03 | 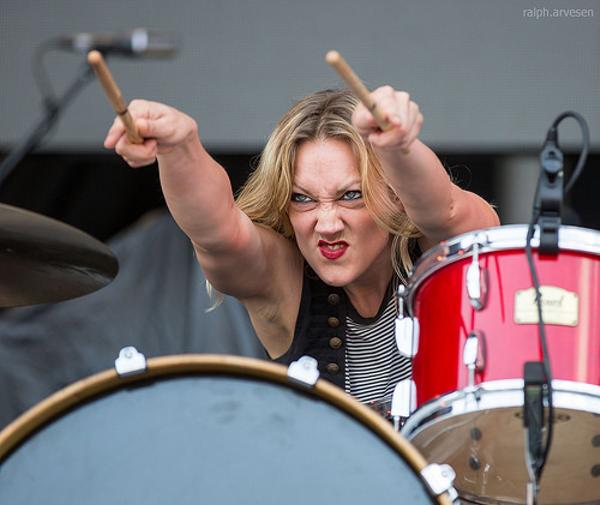 |
这些文字题来自这个盘点向视频 ,图片题的答案来自这个网站 Bokete。出题角度很多元,既有回答套路相对固定的错位场景,也有“每 8 秒发生一次的是什么行为”这种抽象问题。
每道题收集 5 组回答,分别来自 4 个模型(Claude Opus 5.5、GPT 6.1 Sol、GPT 6 Astra 和 Gemini 4 Argon)和精选人类回答(文字部分全部来自喜剧艺人笨蛋节奏,图片部分来自 Bokete)。
打乱顺序之后,让这 4 个模型和我本人按照主观喜好盲评排序。从 1 分到 5 分,数值越高表示排名越靠前,不设并列。
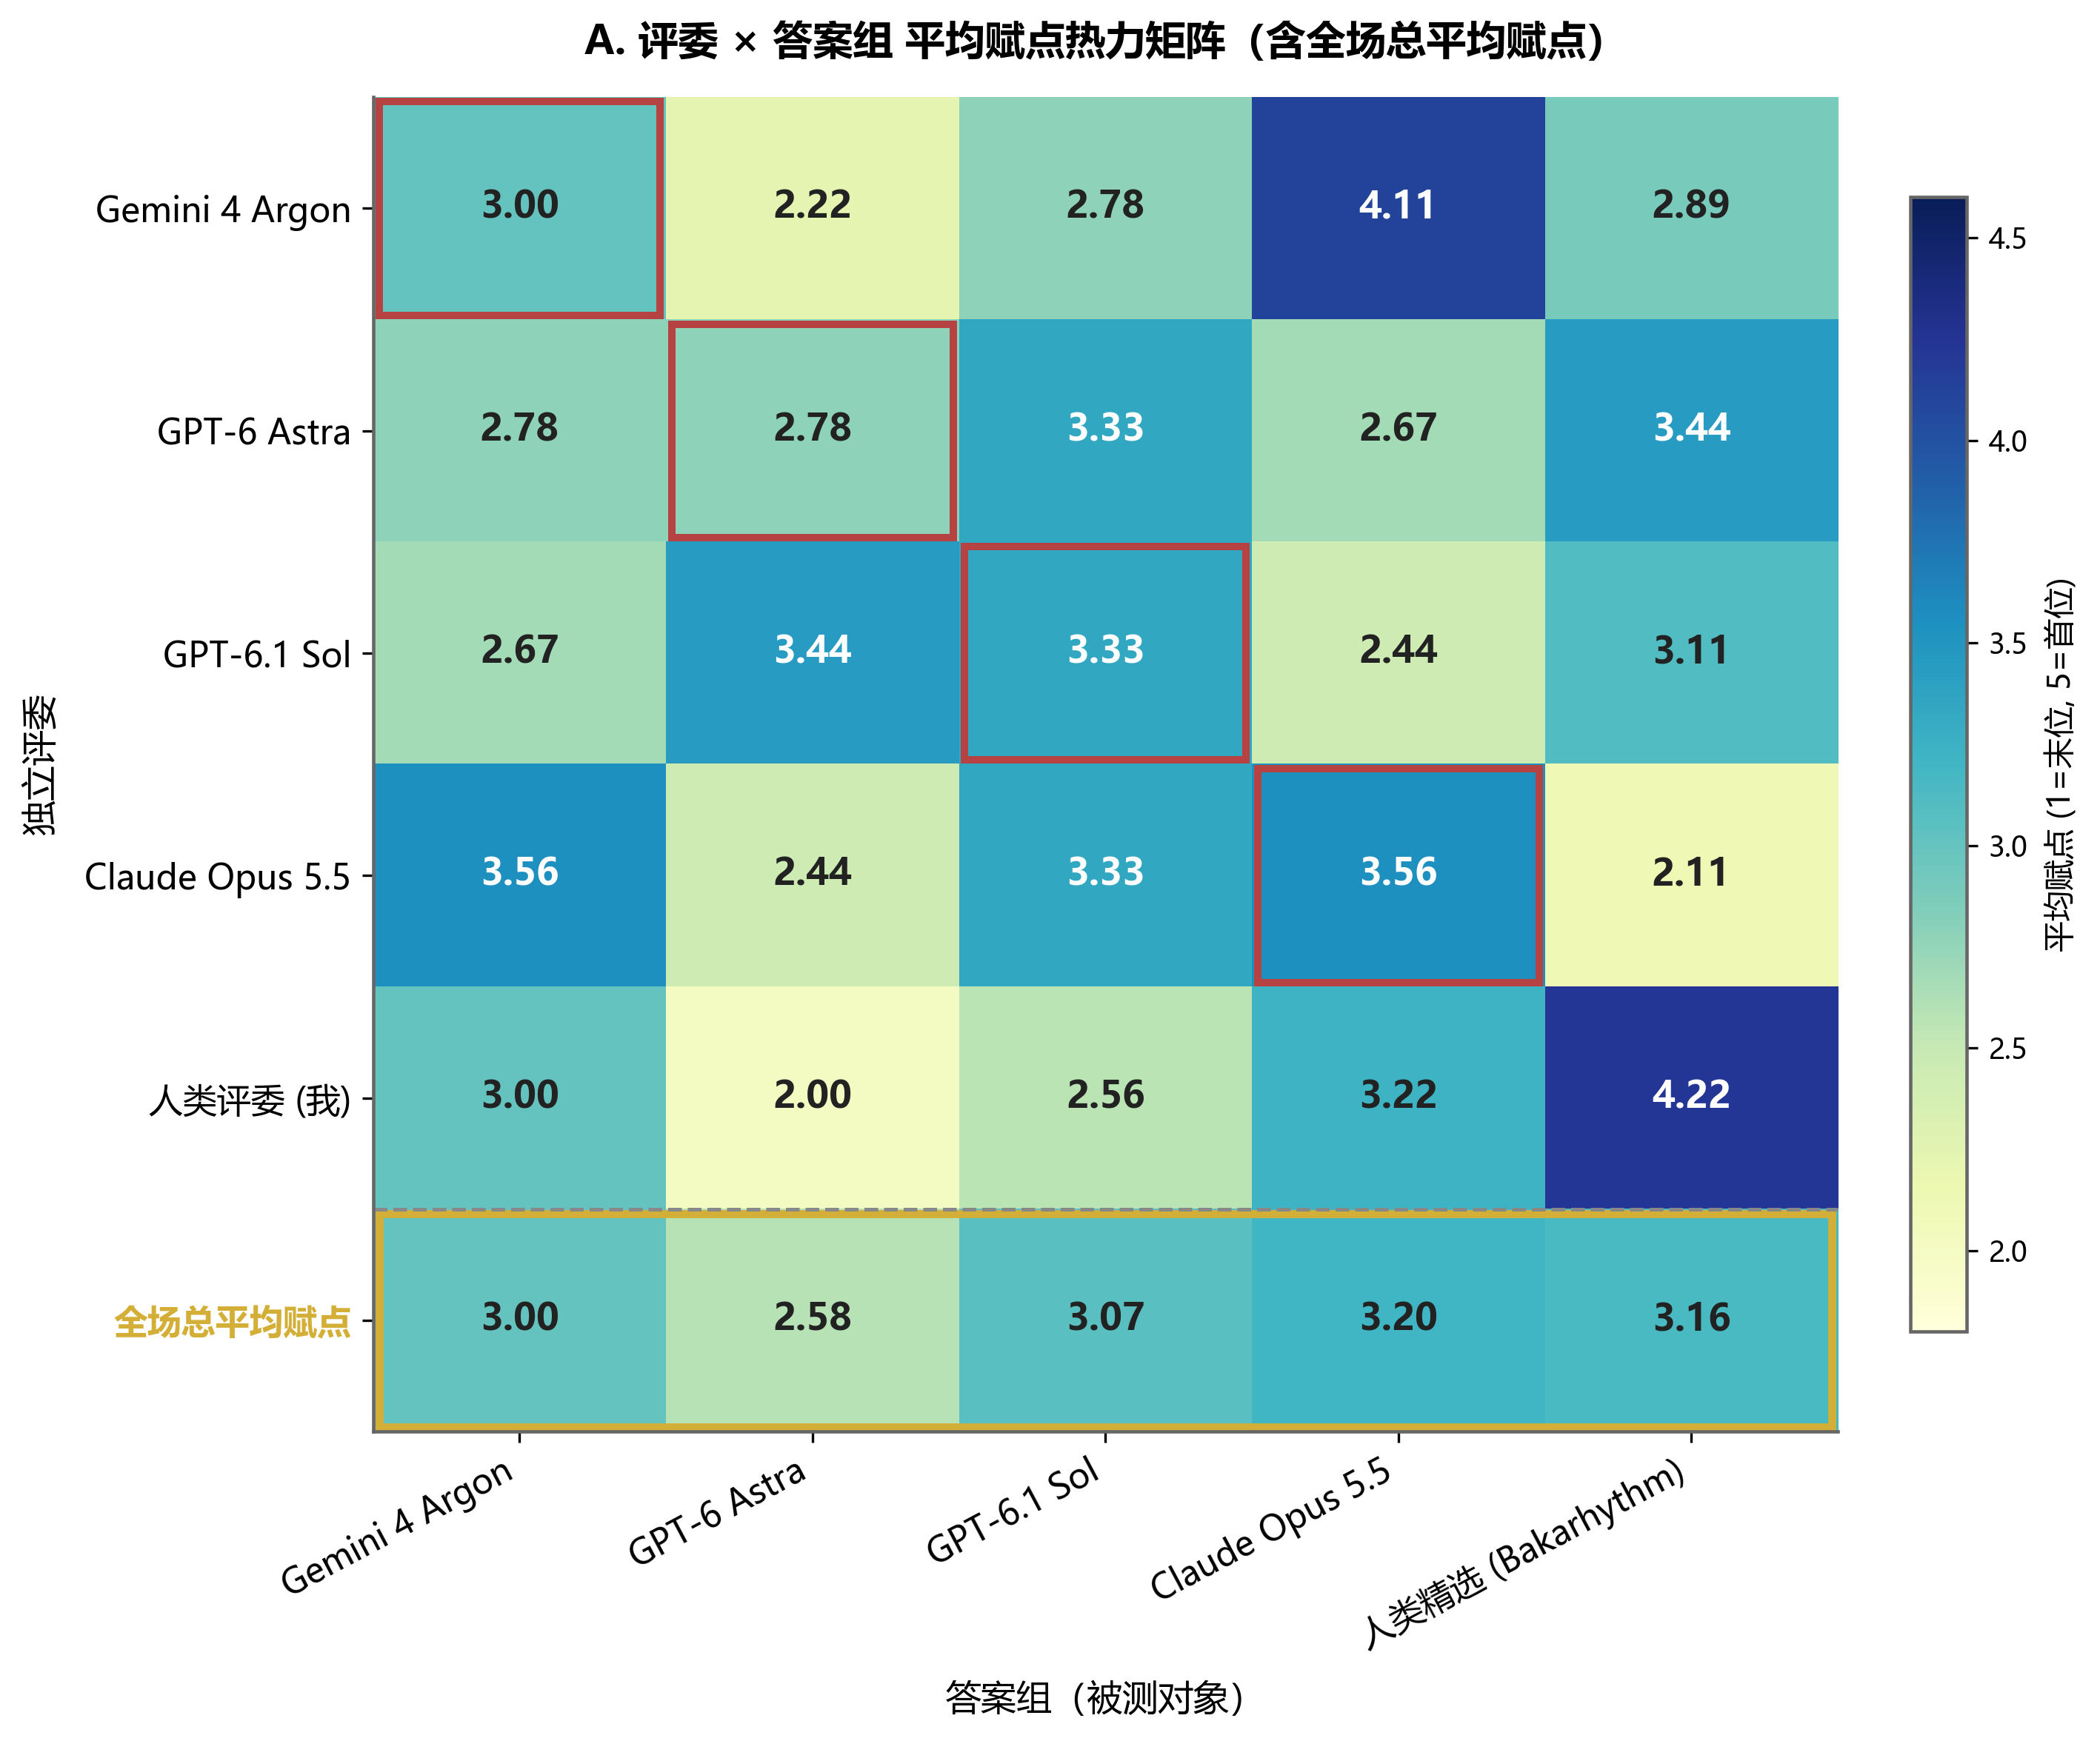
这是互评平均分的热力图。
可以看出 Claude Opus 5.5 自我认同最强,给自己打了最高分,给笨蛋节奏的回答打了最低分。整体上看 Claude Opus 5.5 的得分也略胜笨蛋节奏一筹。
这里要补充一句,我当然知道让 AI 评价人类的幽默水平很奇怪。有日本综艺会让 AI 答大喜利,但我没见过让 AI 评价大喜利回答的。况且我也不太认同这些模型的评价(我的评价也在图里)。只是正如图灵所说,“只有机器才会欣赏另一个机器写出的十四行诗”,你可以把这个视作“关于幽默的图灵测试”(图灵测试本意指的不是这个),毕竟幽默感也包括理解幽默的能力——模型认为什么回答是幽默的。
在 Opus 这里 Argon 是和自己并列第一,而在 Argon 这边,Opus 比自己还要强出一个身位,真是惺惺相惜。
我们可以具体算一下相关系数,定量地看一下评委的品味相似度。
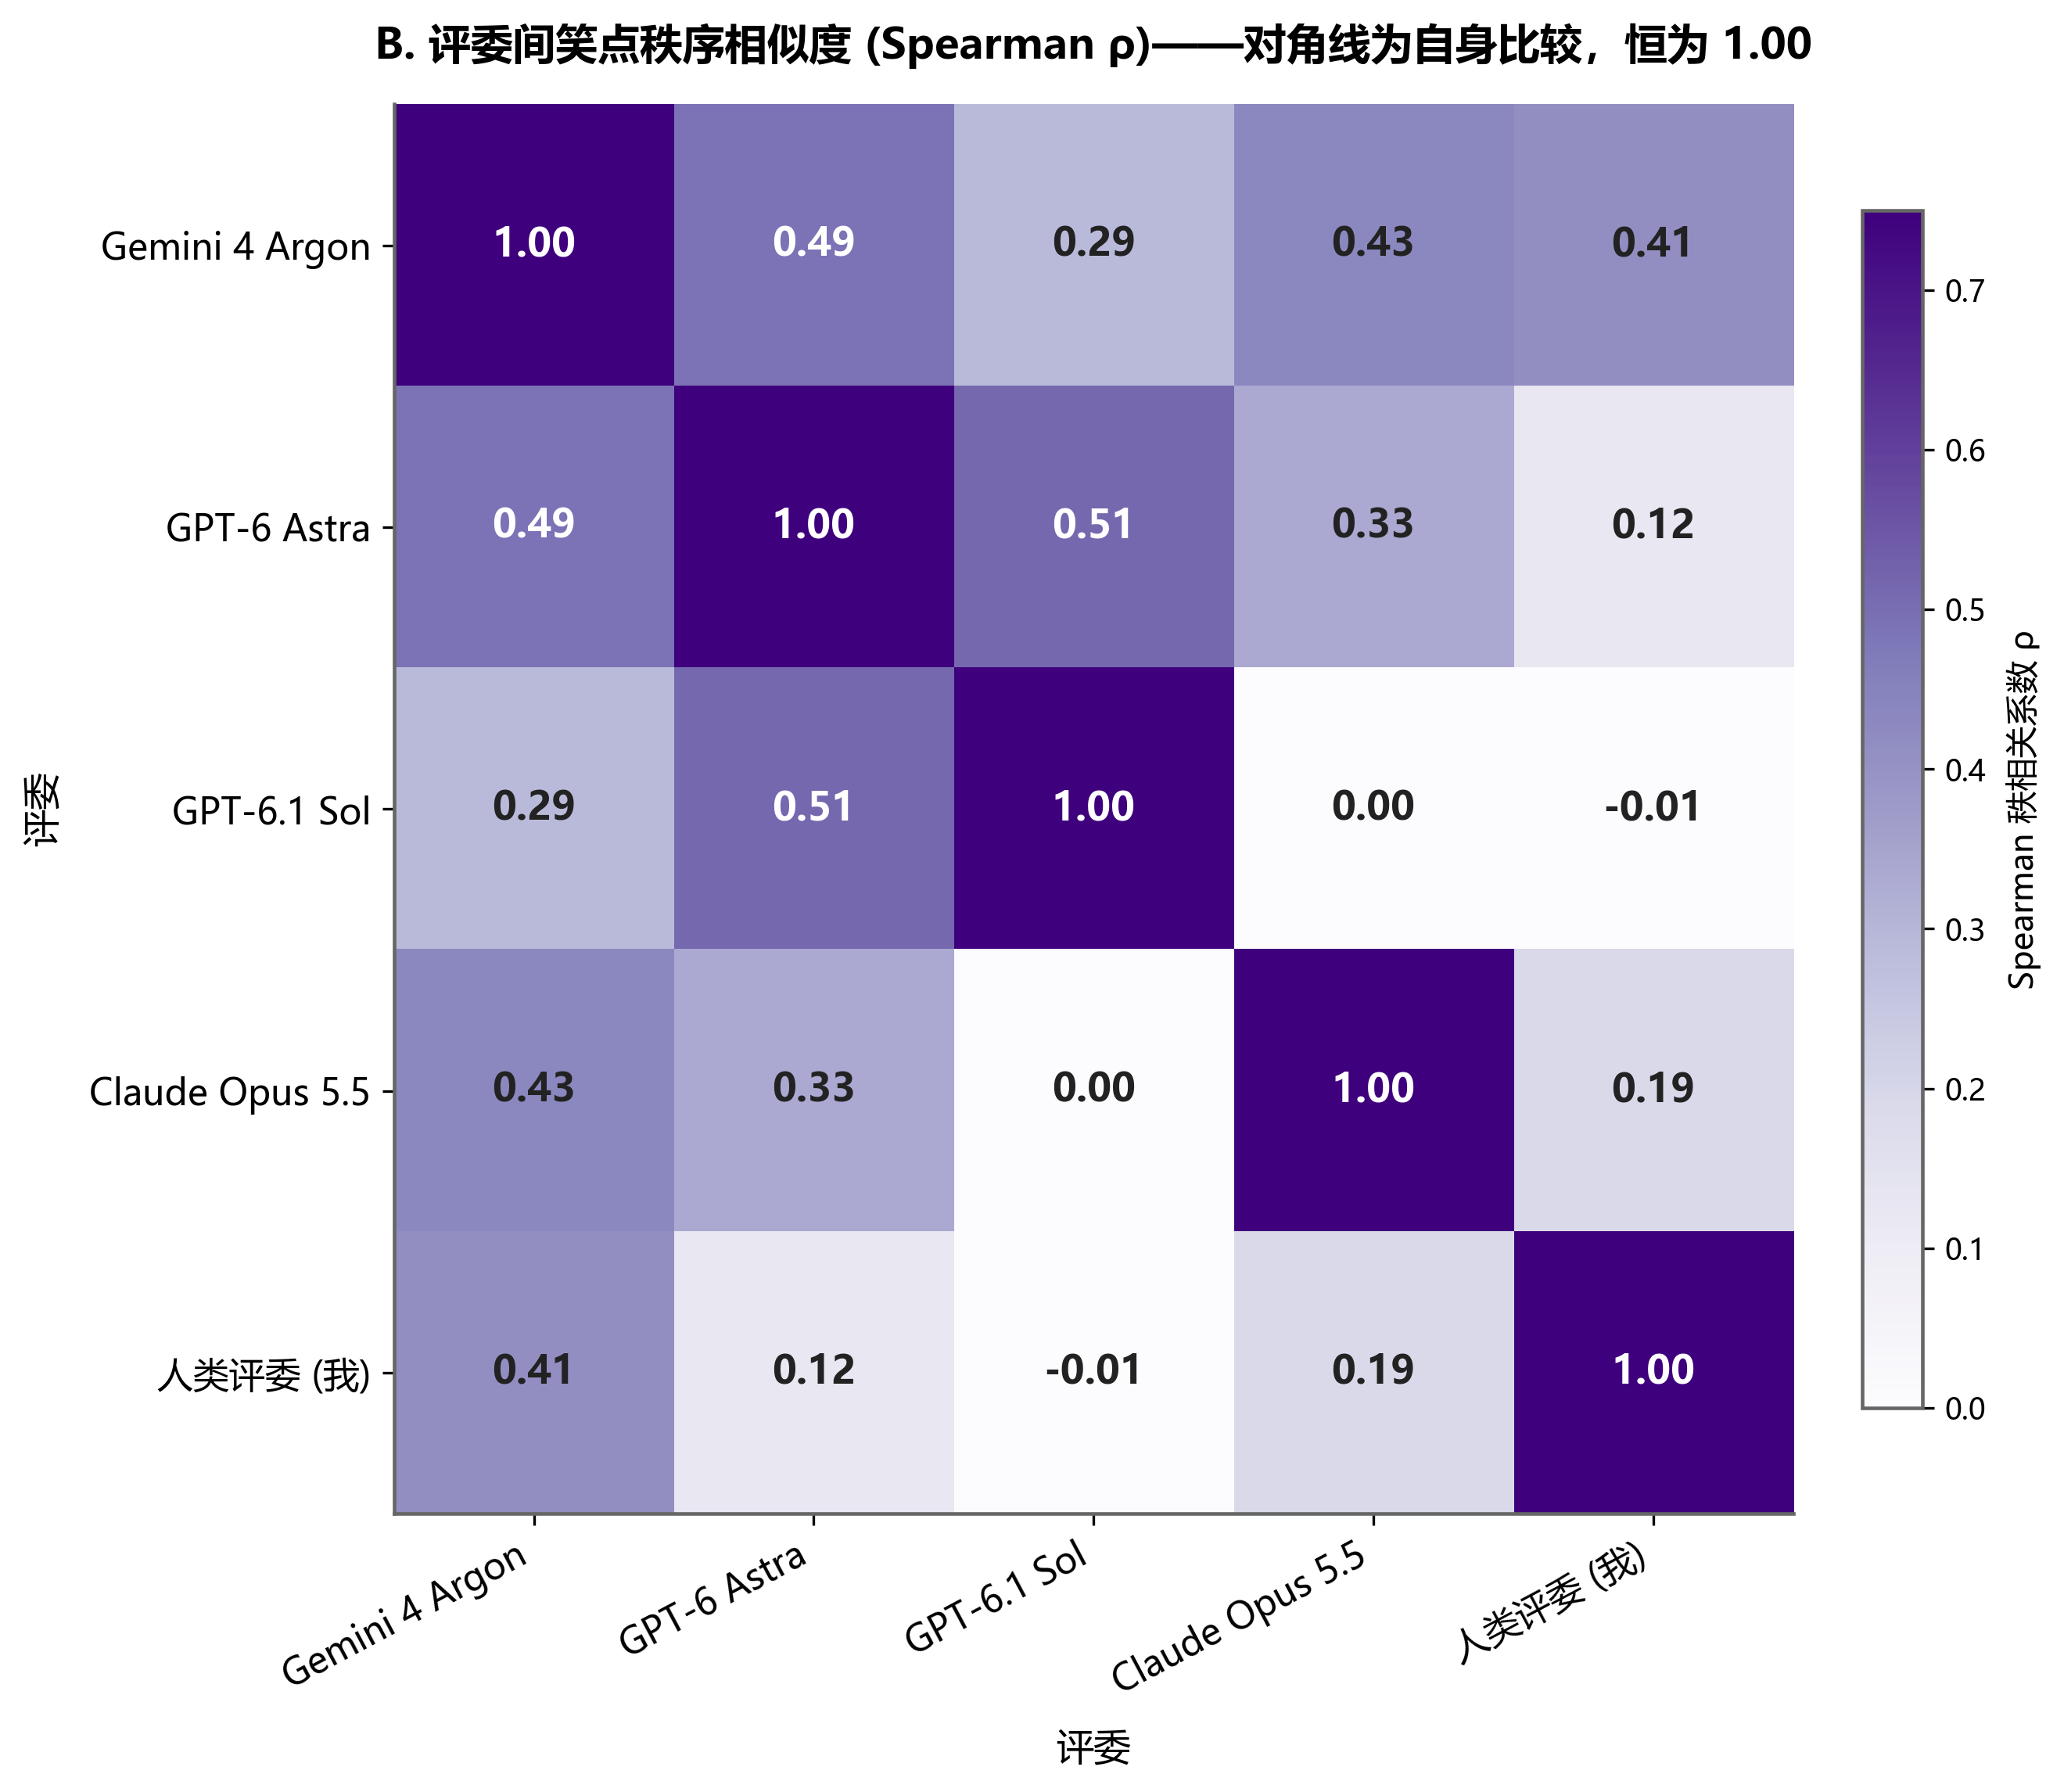
图中颜色越深(数值越接近 1)说明品味越相近,颜色越浅(数值越接近 0)说明品味越不相关。按理说还可以存在负数,代表品味完全相反,但图中几乎没有,我和 GPT 6.1 Sol 也只能算“无缘”。
还可以把这个结果“翻译”到空间中:
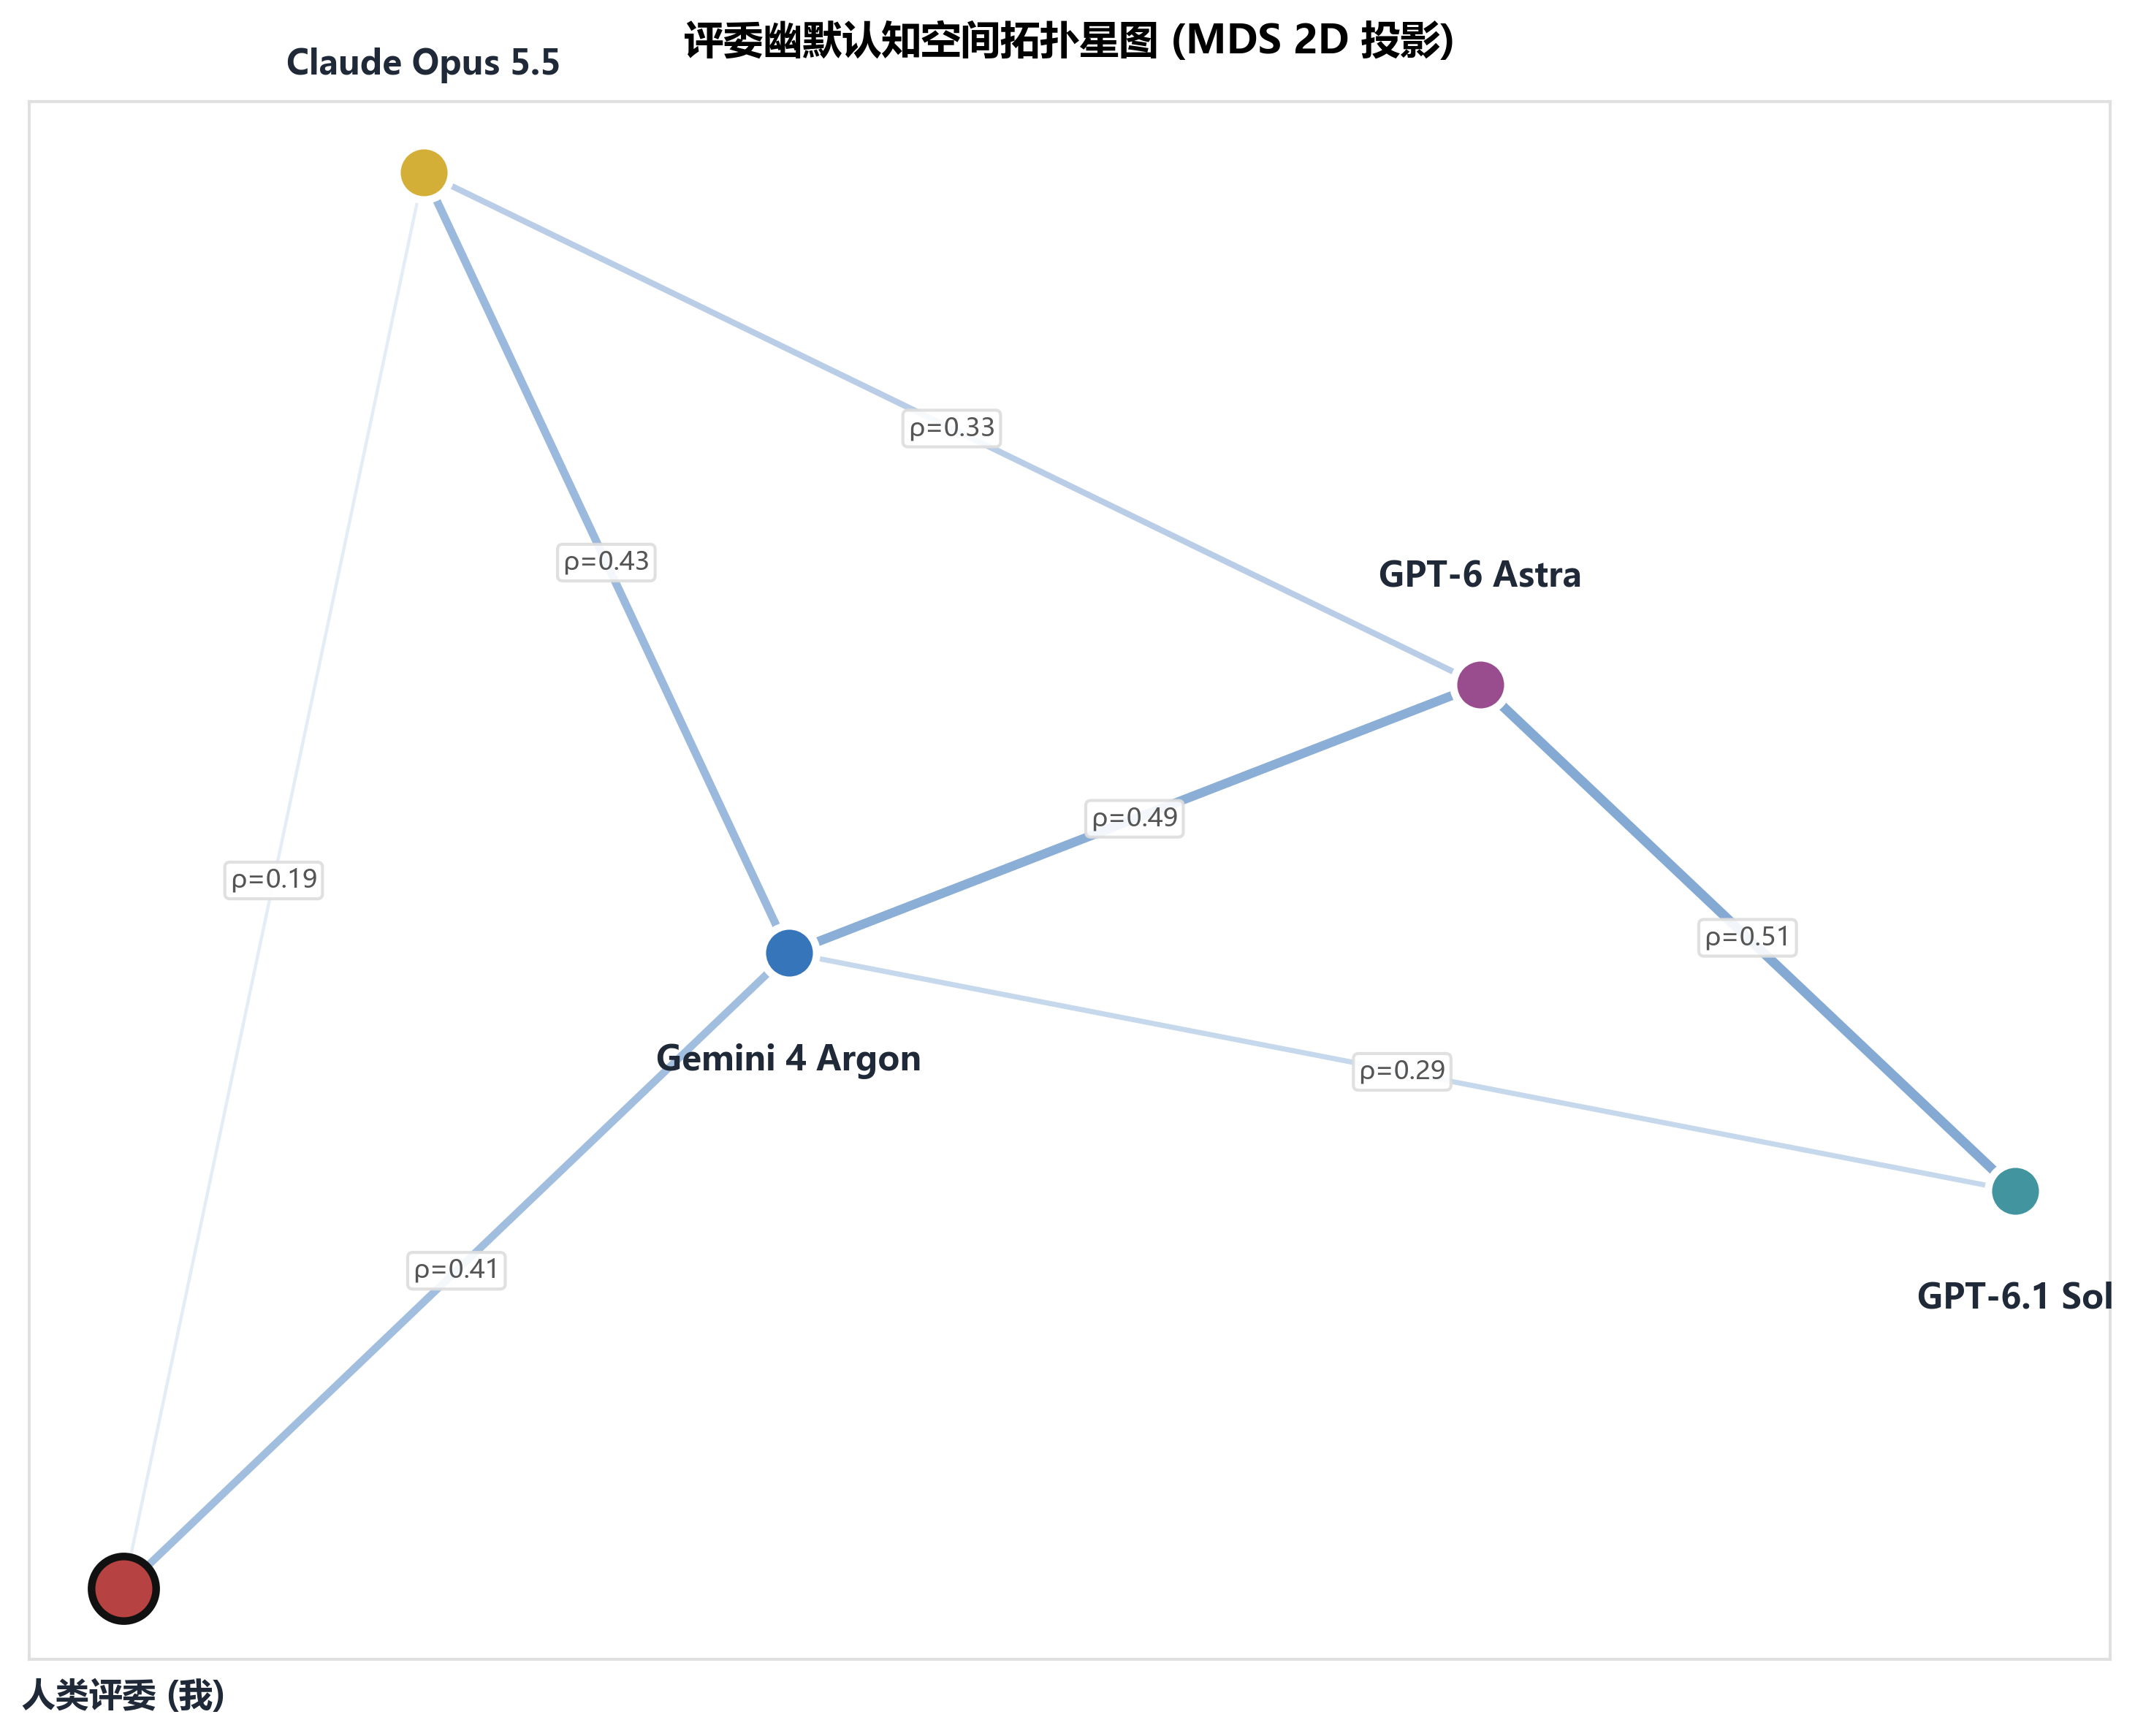
图中点与点的间距越近、连线越粗,就说明品味越接近。你可以看到与我最投缘的是 Gemini 4 Argon,也许选择模型除了看能力强弱,也要看能不能笑到一起去。
我们之间唯一的阻碍,就是额度掉得太快。
前面给了平均分,但大喜利更像是跳高,观众在乎的是最高的那次有多高(作家朱岳打过的一个比方)。
下图是各个模型被评为“最佳回答”的次数:
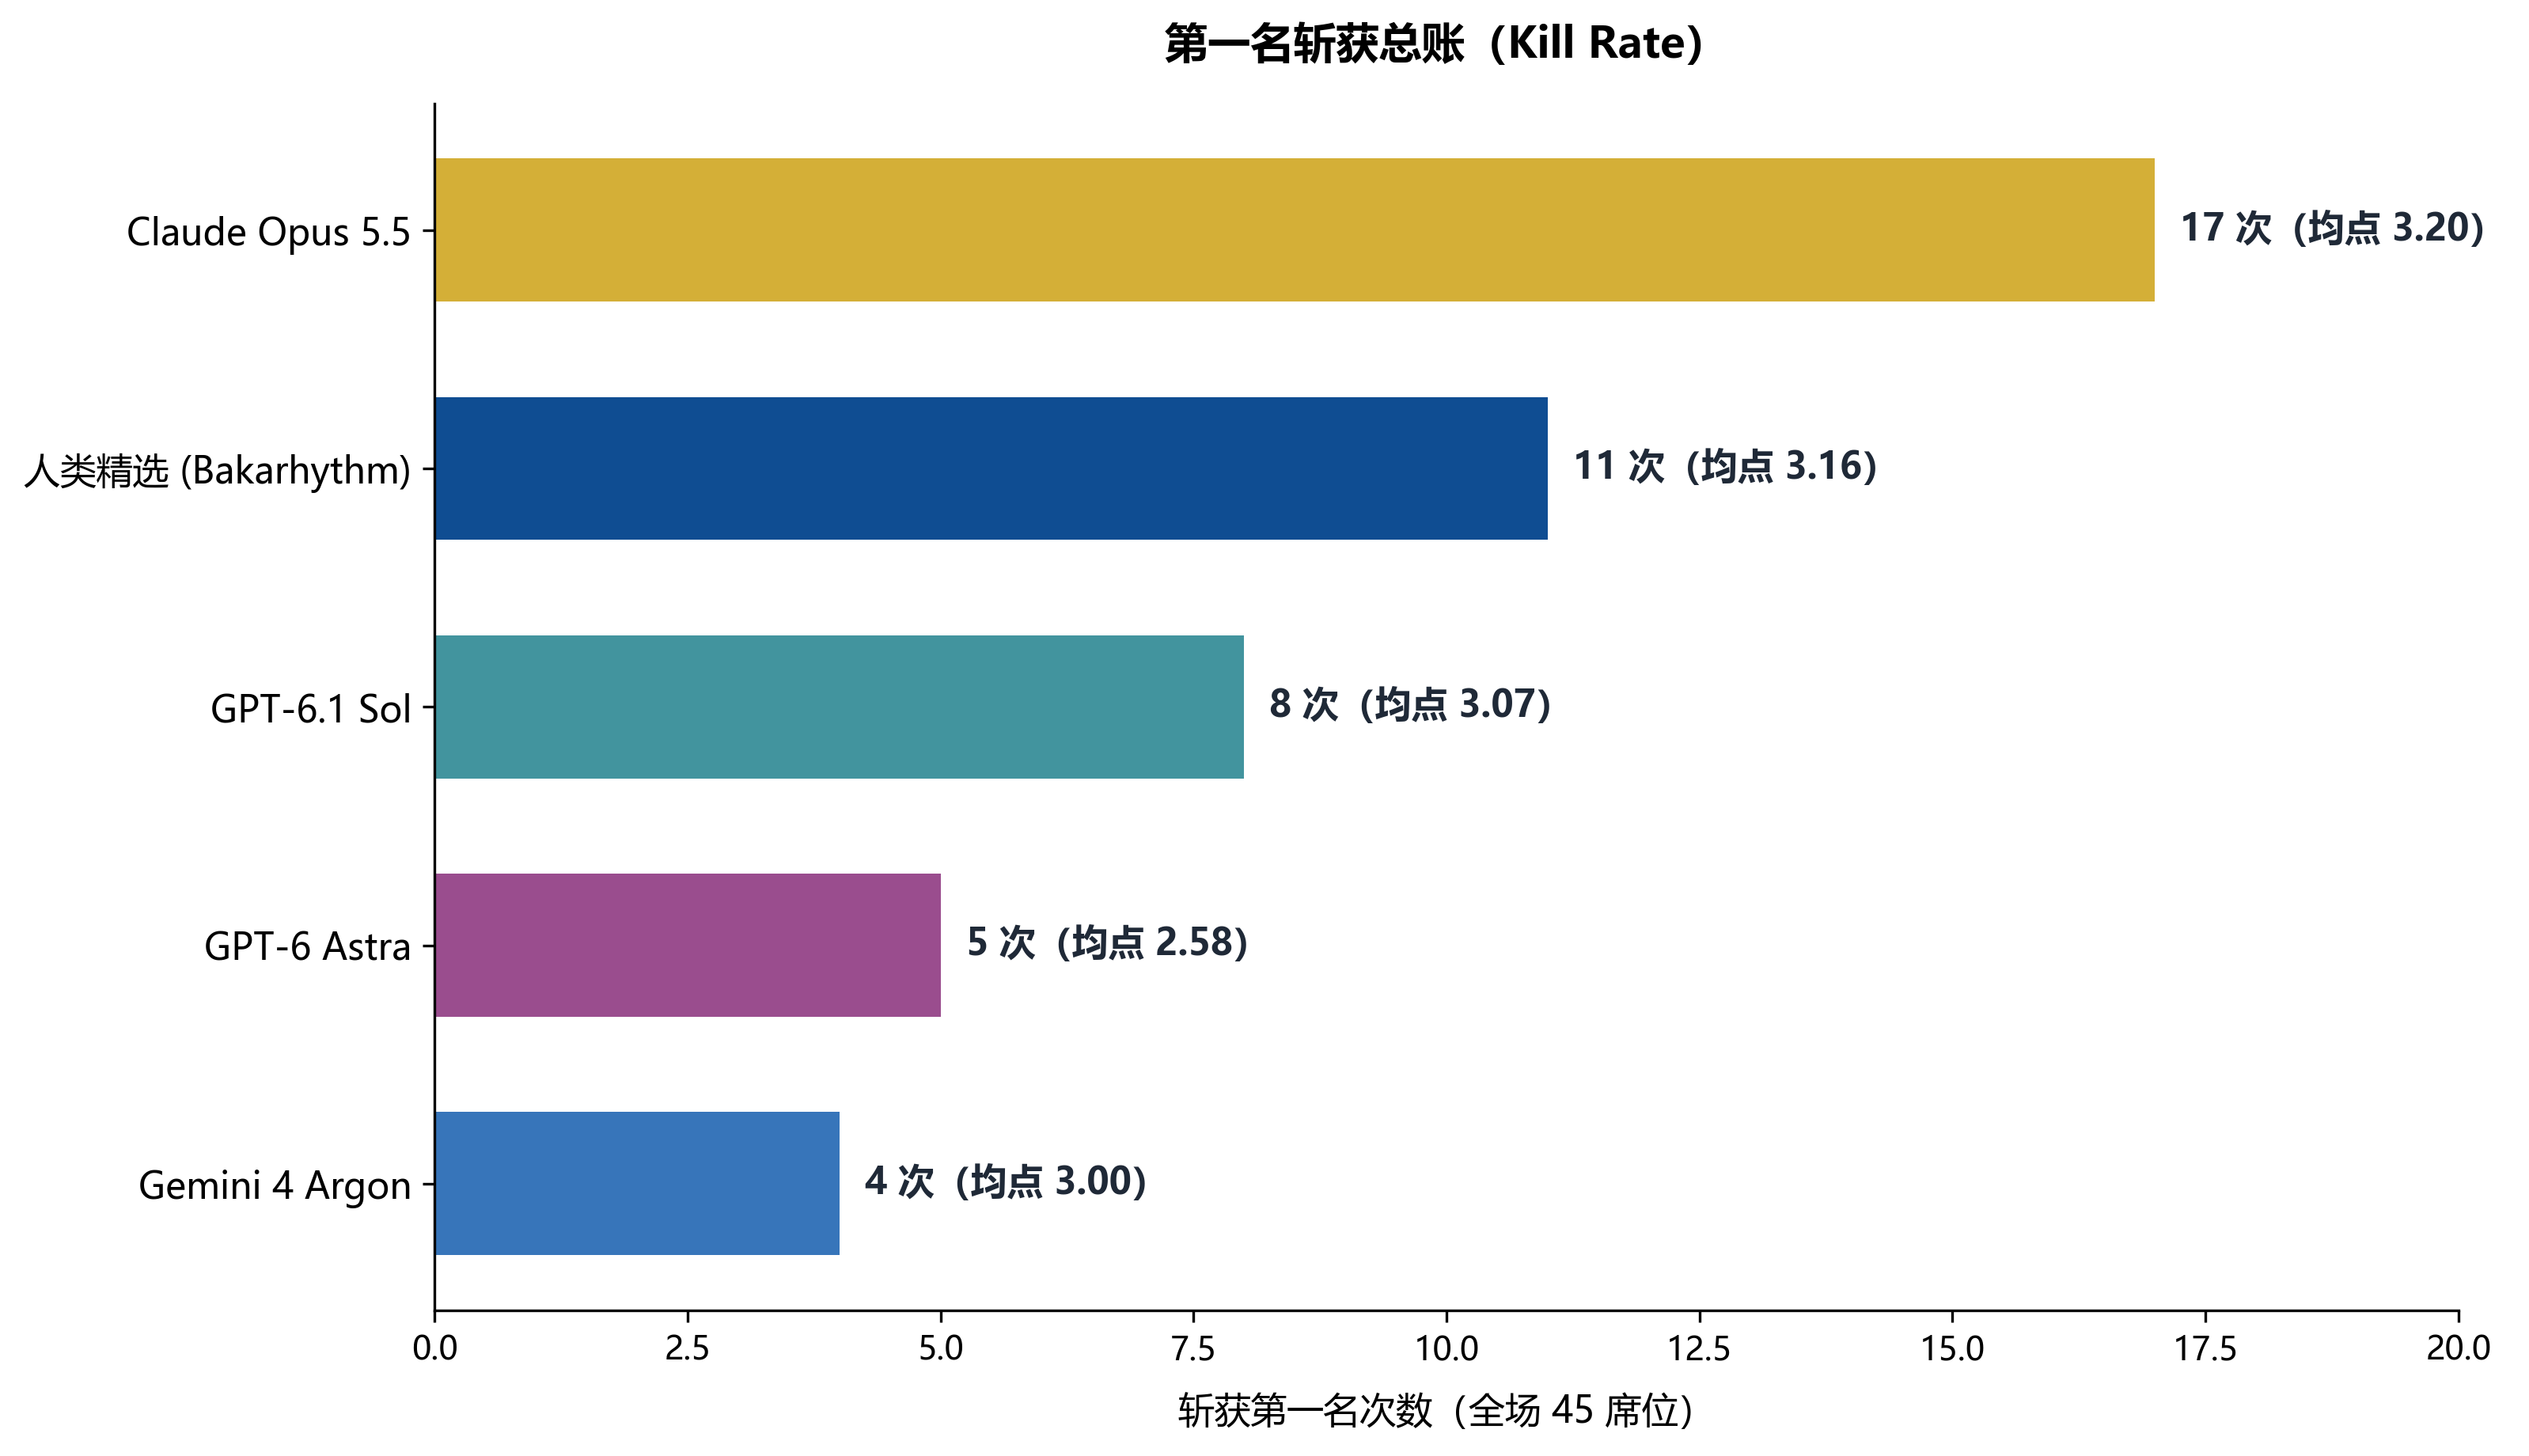
在 AI 界,Opus 的大喜利能力可谓断层领先,而 Argon 则相对不受待见。
下图则是每道题的明细,图中包括每位评审的具体第一选择、第一选择的众数以及共识度:
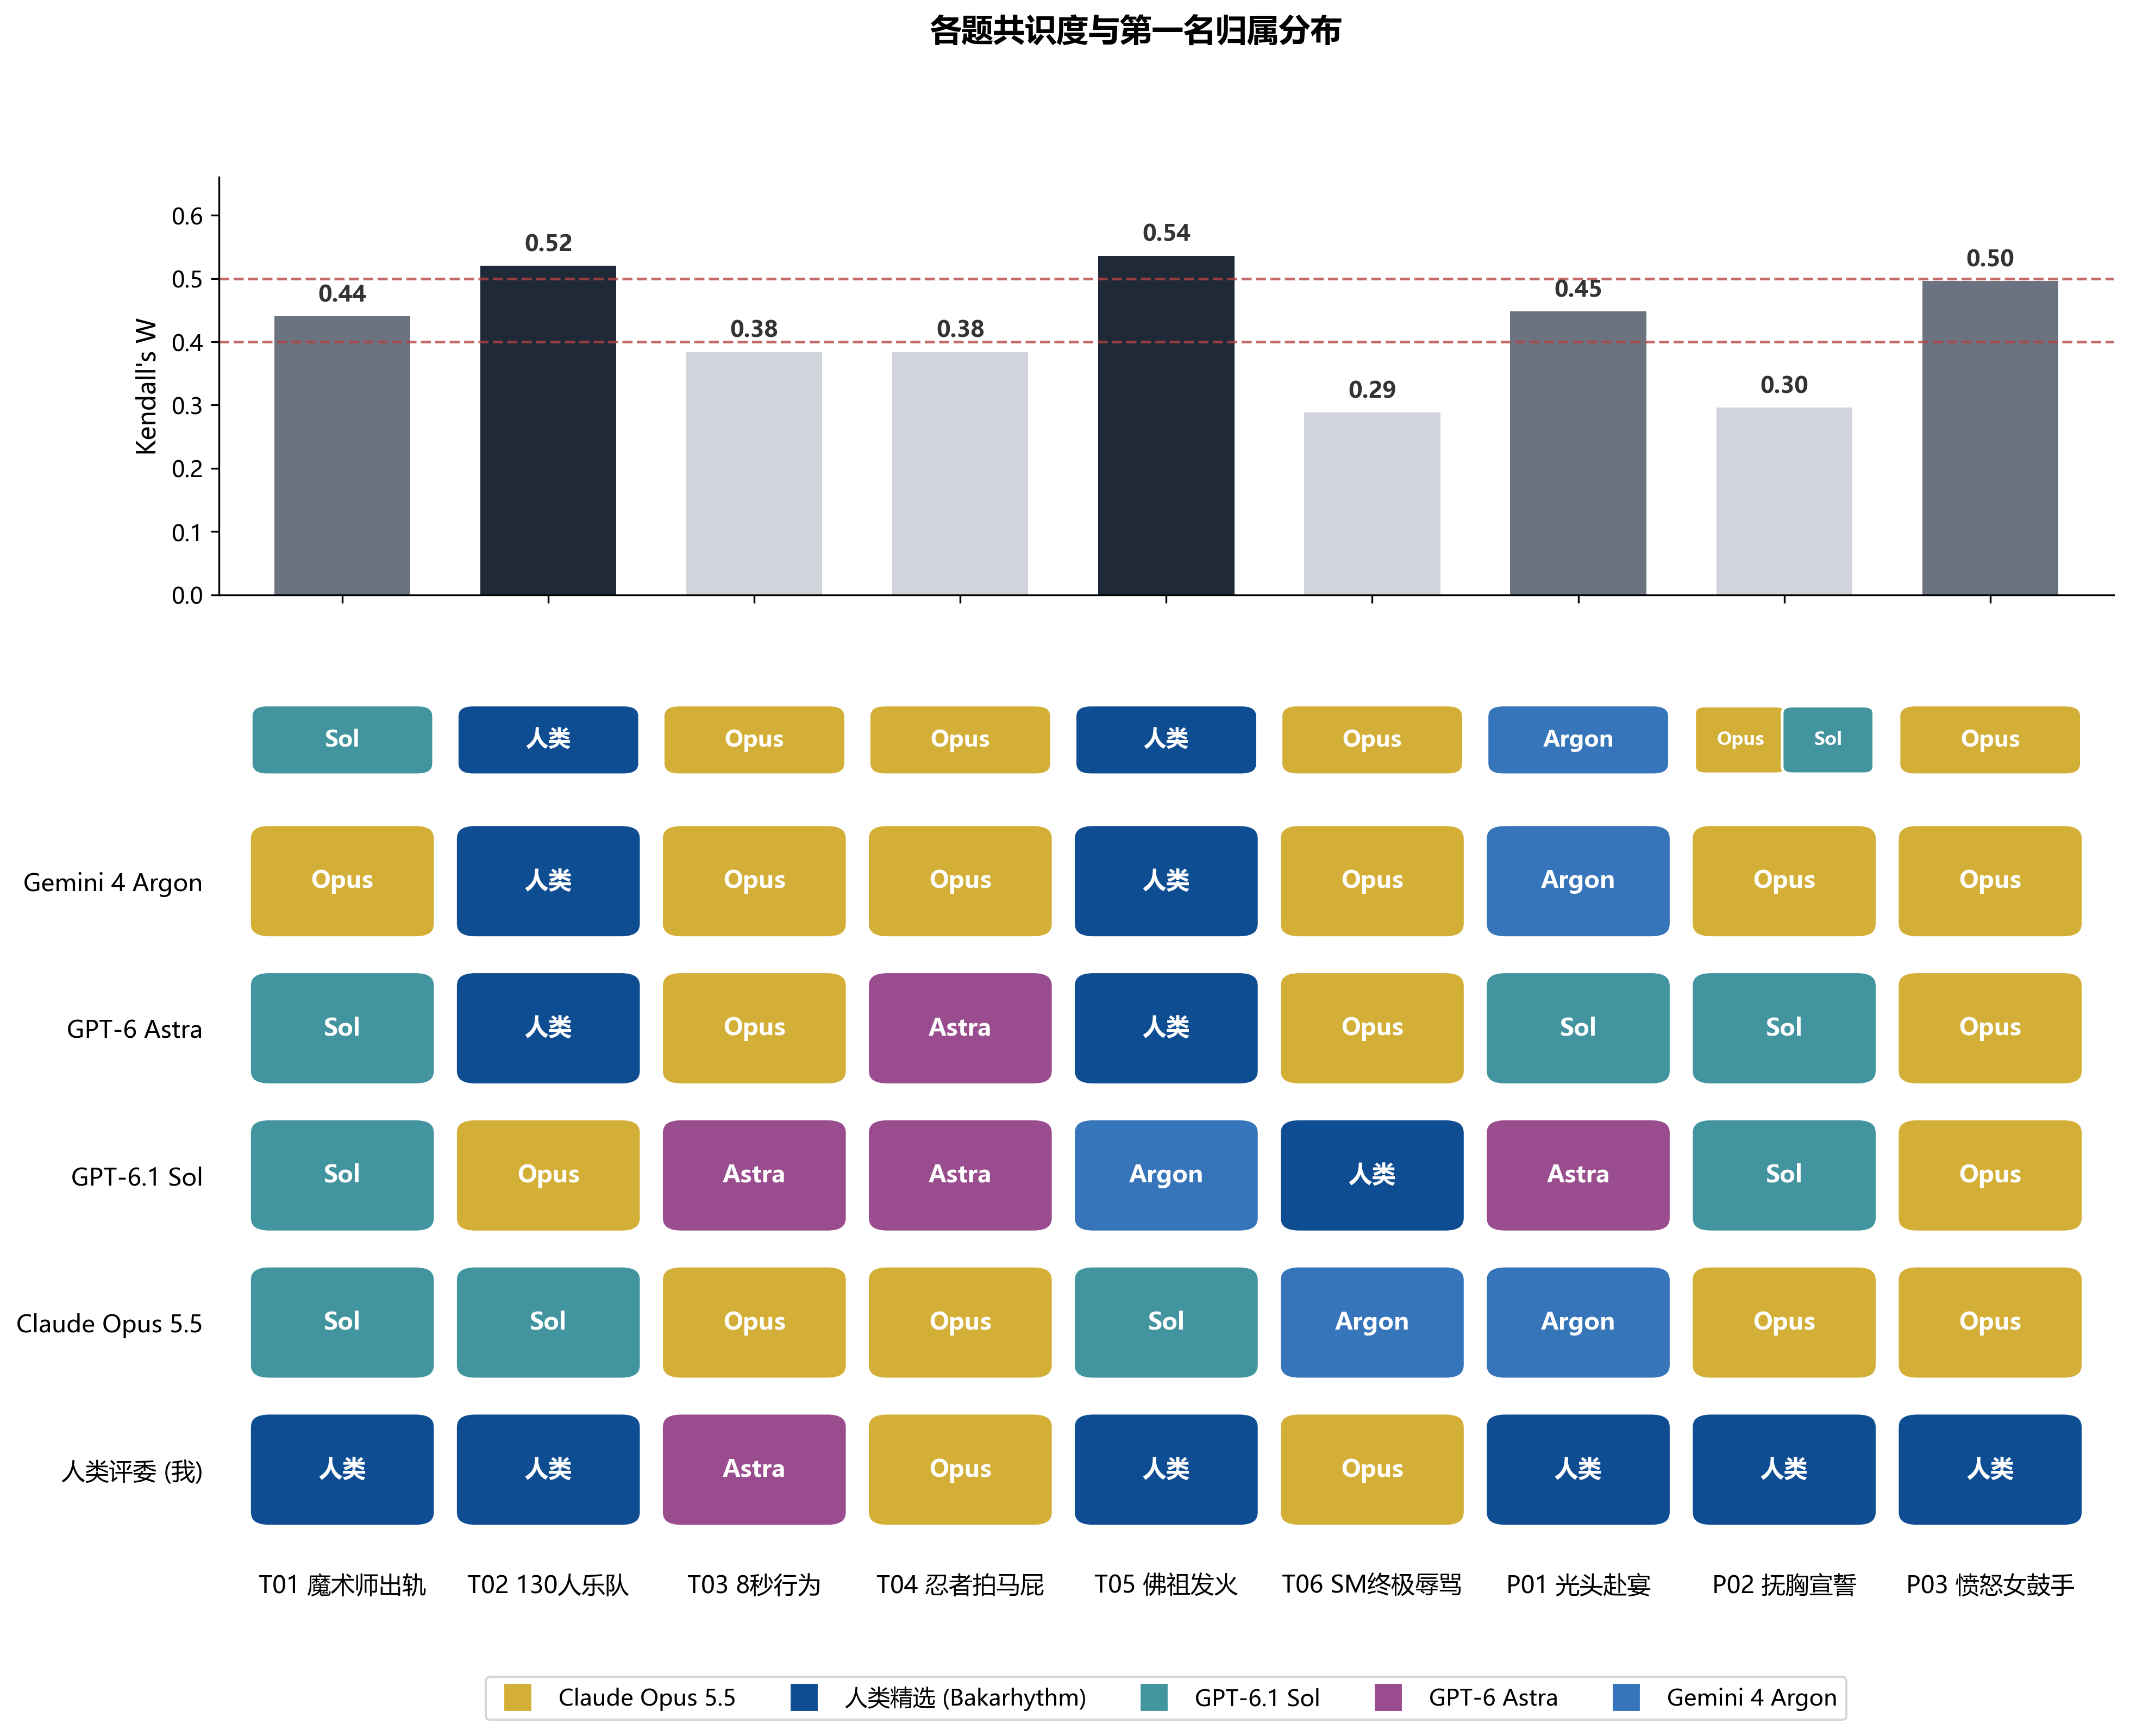
共识度高,代表选项具有压倒性。共识度低,则代表本题各个选项水平比较平均,难分伯仲。比如笨蛋节奏被评为第一的两组回答(T02 和 T05),共识度位列前两名,数值都超过了 0.5,说明回答质量还是很高的。
每 8 秒发生一次的是什么行为?
某个领域自称不会被 AI 取代,真正的底气在于不受重视。
比如幽默,我们也许会认为这是没有必要“传授”给 AI 的。可能是我们没那么看得起 AI,不会想去认真读它不断吐出的文字。因为没有人读,这种文字也进一步失去了可读性。
另一种可能是,我们没那么看得起幽默,AI 干点什么不好。
下面是 9 道题的回答,来自 AI 现阶段对于幽默的理解。
按照我的理解,虽说答题思路相同,“胸前这家赞助商没续费,不能让它上镜”显然不如“穿着 Nike 去了 Adidas 的典礼”,后者更具体,因而更有喜感。Opus 斩获四票的答案,“第五排戴帽子那个,陈小宇,你跟班主任说的今天发烧”更是使我空虚乏力,不知这种与图片信息几乎无关的“通用回答”为何颇受青睐。
但还是一并附在这里,也算是一份心意。
| 题号 | 摘要 | 票数冠军 | 第一名回答 |
|---|---|---|---|
| T01 | 妈妈和魔术师出轨了,你是怎么发现的? | Sol(3 票) | 衣柜里的叔叔坚持让我检查柜子没有夹层 |
| T02 | 史上首个 130 人组成的摇滚乐队解散,理由是什么? | 人类精选(3 票) | 一排练就跳闸 |
| T03 | 每 8 秒发生一次的是什么行为? | Opus(3 票) | 退役牛仔骑孙子的摇摇马,每满 8 秒就翻身落地举帽致意 |
| T04 | 拍马屁的忍者对前辈忍者说了什么? | Opus(3 票) | 前辈,您这十个分身里,我最敬佩的就是本体您 |
| T05 | 俗话说佛也有三次好脾气,第一次见面就把佛惹火的行为是什么? | 人类精选(3 票) | 好嘞,这是第一次哦——!! |
| T06 | 精通 SM 的传说女王大人最终领悟的终极辱骂台词是什么? | Opus(3 票) | 你这抖的频率不对劲,回去查查甲状腺 |
| P01 | |
Argon(2 票) | 不是说好今天全体男宾都把假发摘了吗 |
| P02 | |
Opus / Sol(各 2 票) | 心率九十二,这场我得先把自己换下去(Opus);胸前这家赞助商没续费,不能让它上镜(Sol) |
| P03 | |
Opus(4 票) | 第五排戴帽子那个,陈小宇,你跟班主任说的今天发烧 |
