在想出这套去 AI 味工作流之前,我做了两个假设:
一是,好的汉语,也应当好听。
二是,提升 AI 的写作水平,就要教会它作家的写作方式。
用嘴写作的作家
2022 年 8 月,作家王朔推出长篇新作《起初·纪年》。新书付梓前,编辑团队希望他写篇自序,未料王朔是这样回绝的:“现在写不了,最近烟抽得多,嗓子不好。”
写字关嗓子什么事?
他在后来的序言里写道:“我是拿口语所谓新北京话写作的作者,检查文字也须拿口语来回溜,没磕啵儿,才觉得通顺。”嗓子哑了,落笔前就少了一道质检。
作家阿城在《闲话闲说》里也谈过语言的节律:
世界语言最重要的是节奏。我们学西方的长句子造成很多人不知道应该在哪儿断句,不知道怎么断。我采取笨方法,标点符号不仅仅是语法的作用,同时是节奏点的作用。
在古汉语里,标点的前身叫句读。古人讲“因声求气”,停顿断句顺应的是说话换气的生理节拍,不单是按语法切分句子。
很多文章让人读出公文腔、翻译腔或者扑面而来的 AI 味,不是说语法有什么问题,毛病出在文字没有留出换气的空间。层层套叠的修饰从句、整齐机械的排比、连绵不断的转折连词,这些去 AI 味的提示词里所指出的,好像都是“气口”的问题。
就像歌手对现阶段 AI 音乐的诟病之一,就是 AI 唱起歌来,不换气。
把文字拉进声音里
顺着这个思路,我自制了去 AI 味 Skill Qikou(气口),把“用嘴写作”的直觉落实为“先读后听”的工作流。
引入了 TTS 用以音频生成,再利用上 Gemini 模型的多模态能力。
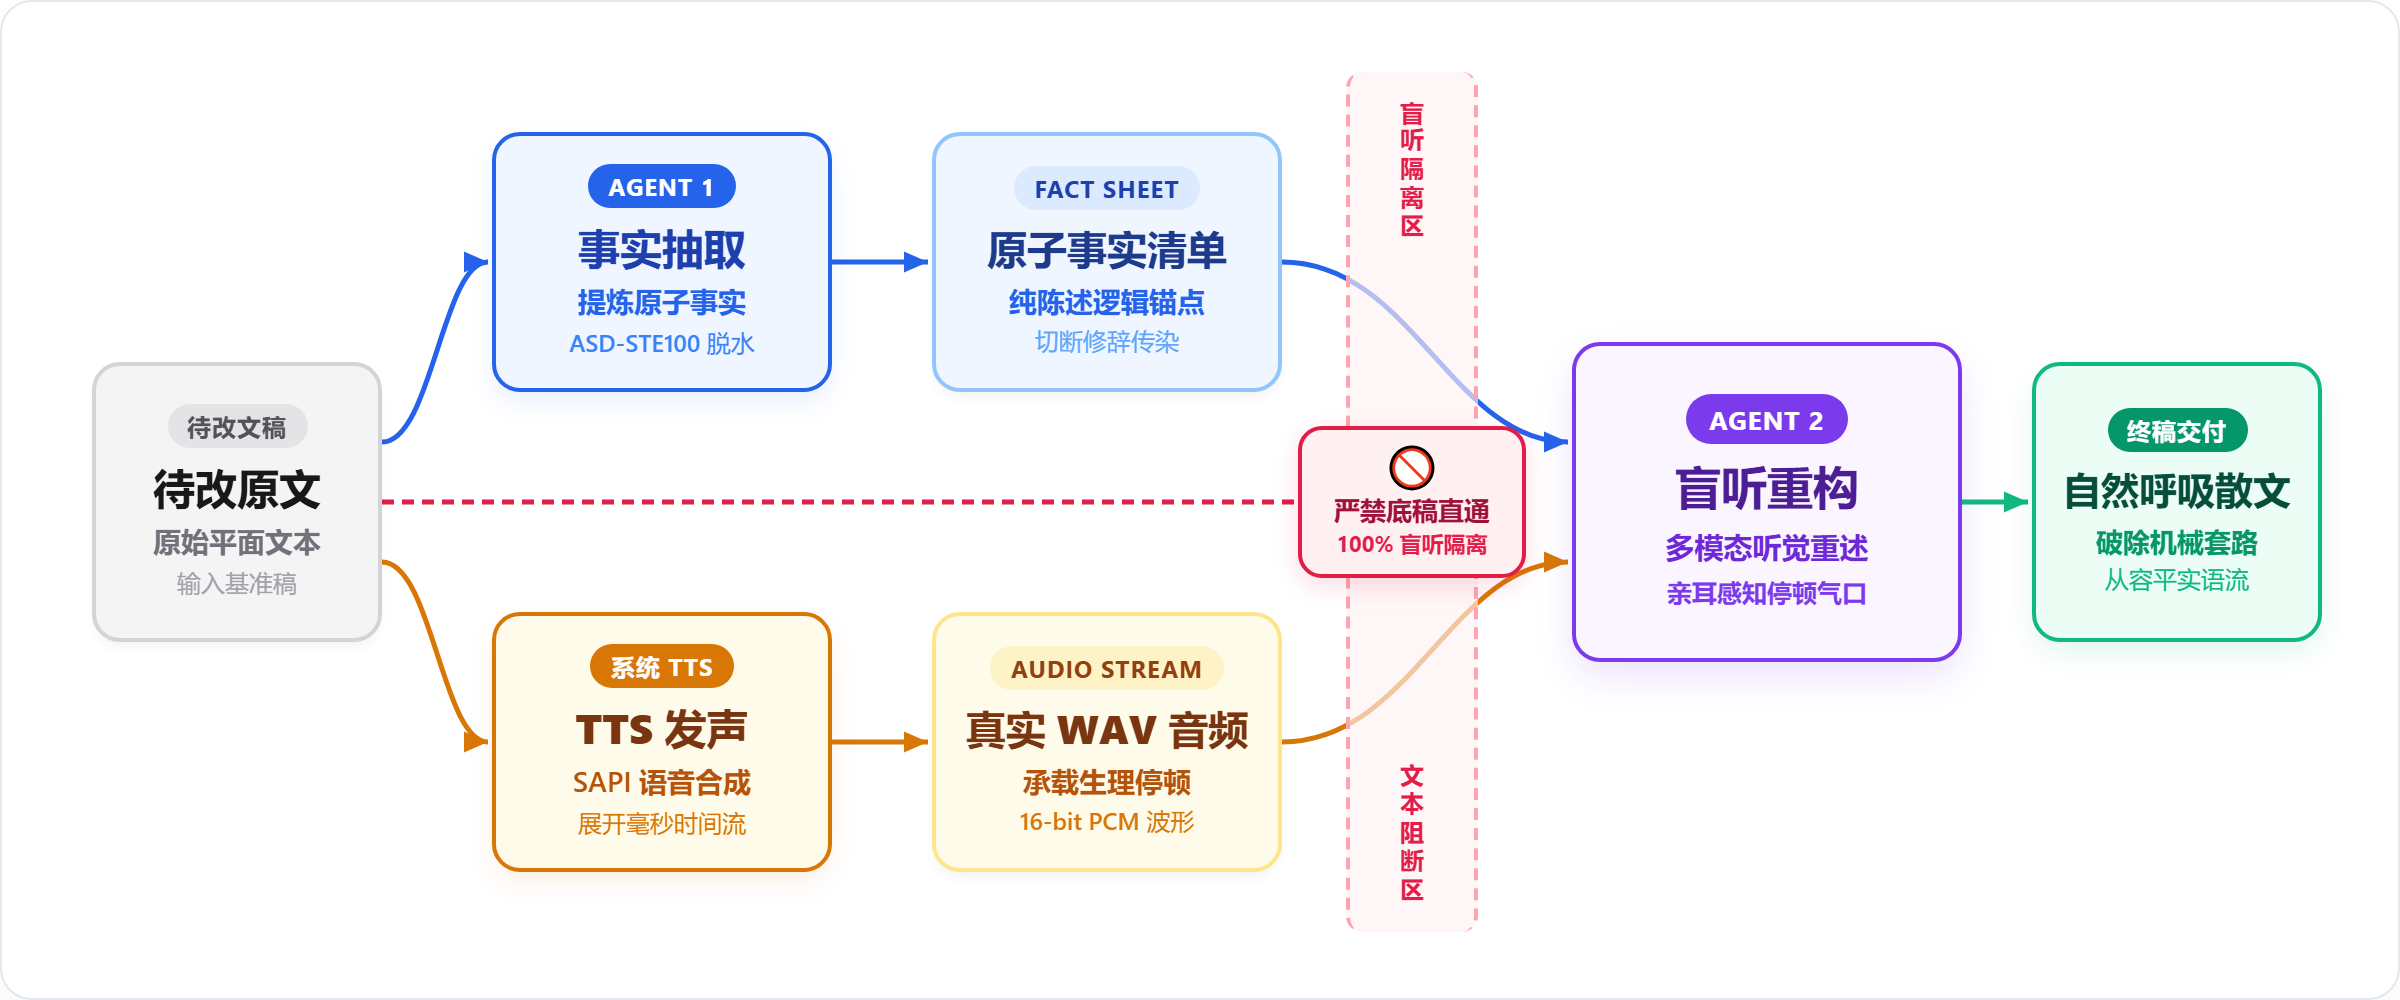
Agent 1 专门负责拆解文本中的关键信息。
这一步的规则,源于安德烈·卡帕西(Andrej Karpathy)提及的一套航空工程标准——简明技术英语规范(ASD-STE100)。
我借用了最核心的原子化陈述约束:一句话只陈述一个独立事实,保留确切数字、参数、实体、专有名词与逻辑因果链;彻底剥离所有主观修饰词、文学比喻和套路过渡词,全程严禁随意轮换同义词。最终交付给下游的,是一份说明书般的原子事实清单。
本地脚本通过系统级 TTS 接口,将原始文本合成 16-bit PCM 格式的真实音频文件(.wav),之后交付给 Agent 2。
Agent 2 处于严格的盲听隔离中,上下文中看不到任何原始文本。它的输入只有两样:本地调入的音频文件,以及 Agent 1 整理出的原子事实清单。
除了音频转写之外,提示词部分还参考了 lieflat-less-ai-tone 这个 Skill。要求句子遵循口语交谈的逻辑,正面给出结论,剔除各类翻案预设。拿掉破折号与各种提示性冒号,完全根据换气节拍安放逗号。
相比其他去 AI 味 Skill,负面清单已经相当精简。
我尝试去找理论依据,但 Agent 表示没有什么论文用过这个思路。
在我看来(只能在我看来),让多模态大模型“听写”,之所以能改变文字质感,原因在于语料库的底层分布。
多模态音频语料中,真实的人类口语对白、播客交流与现场广播依旧占据主体,受机器生成文本的二次污染相对轻微。多模态模型以听觉信号作为感知入口时,激活的是其在海量人类真实口语语料中预训练出的声学节律,避开了纯文本自回归中最容易陷入的语言套路。
这和作家用嘴写作的原理没什么不同。
如果你要写口语白话,或者就是小说里的对话,再或者就是演讲稿,那你当然要亲耳听一下语言是否过关。因为你在生活中听到的多是“人话”,少有书面语、翻译腔或者 AI 味,除非你经常听番茄小说什么的。
三款技能的横向实测
自己造出来的理论不能算数,还是要实际验证一下。
但根据我的经验,直接和朱雀大模型硬碰硬,犹如大战风车,荒谬绝伦。你优化十几轮,骗过了朱雀,得到冗长的工作流。用在其他语段上,发现全然无效,才醒悟,原来我全无胜算。
在我看来,人工智能发展史告诉我们,叠加规则打不过神经网络,你又何必在自己的半径里一再重复这一悲剧呢?
但测试还是要做,退而求其次,我们把 Qikou 与业内两款典型的开源去 AI 工具,做对比测试就行了。
第一位参赛选手是 humanizer-zh。单次提示词驱动,依托 31 条反套话规则清单做局部精剪,最大化保留原文内容,耗时很短。
第二位是 lieflat-less-ai-tone。基于数百篇语料对照总结的三层体系,静态脚本打标配合语义判读,改前生成分级报告由人工确认,耗时比 humanizer 还有 Qikou 都更长。
测试基于 Antigravity 平台,底座模型严格锁定为 Gemini 3.8 Flash,思维强度设定为 low。
评测工具采用腾讯朱雀(Zhuque)AIGC 文本检测接口。核心量化指标为 softmax_confidence,取值 0.0 ~ 1.0,数值越低代表越接近人类真实书写,< 0.50 为判定为人类自然创作的安全区。
长文测试
长文测试样本选自之前发过的纯 AI 写作长篇散文《数据库里的抽卡仪式》中的 4 个小节(S1 至 S4),每节 600 至 1000 字。
| 测试样本 | 原文基线 | Qikou | humanizer-zh | lieflat-less-ai-tone |
|---|---|---|---|---|
| S1(灵韵散场) | 0.9838 |
0.5135 |
0.9884 |
0.6944 |
| S2(真迹不死) | 0.9999 |
0.9779 |
0.9824 |
0.9999 |
| S3(超平面) | 0.9999 |
0.0860 |
0.4077 |
0.9999 |
| S4(抽卡布道) | 0.9921 |
0.6637 |
0.9924 |
0.7561 |
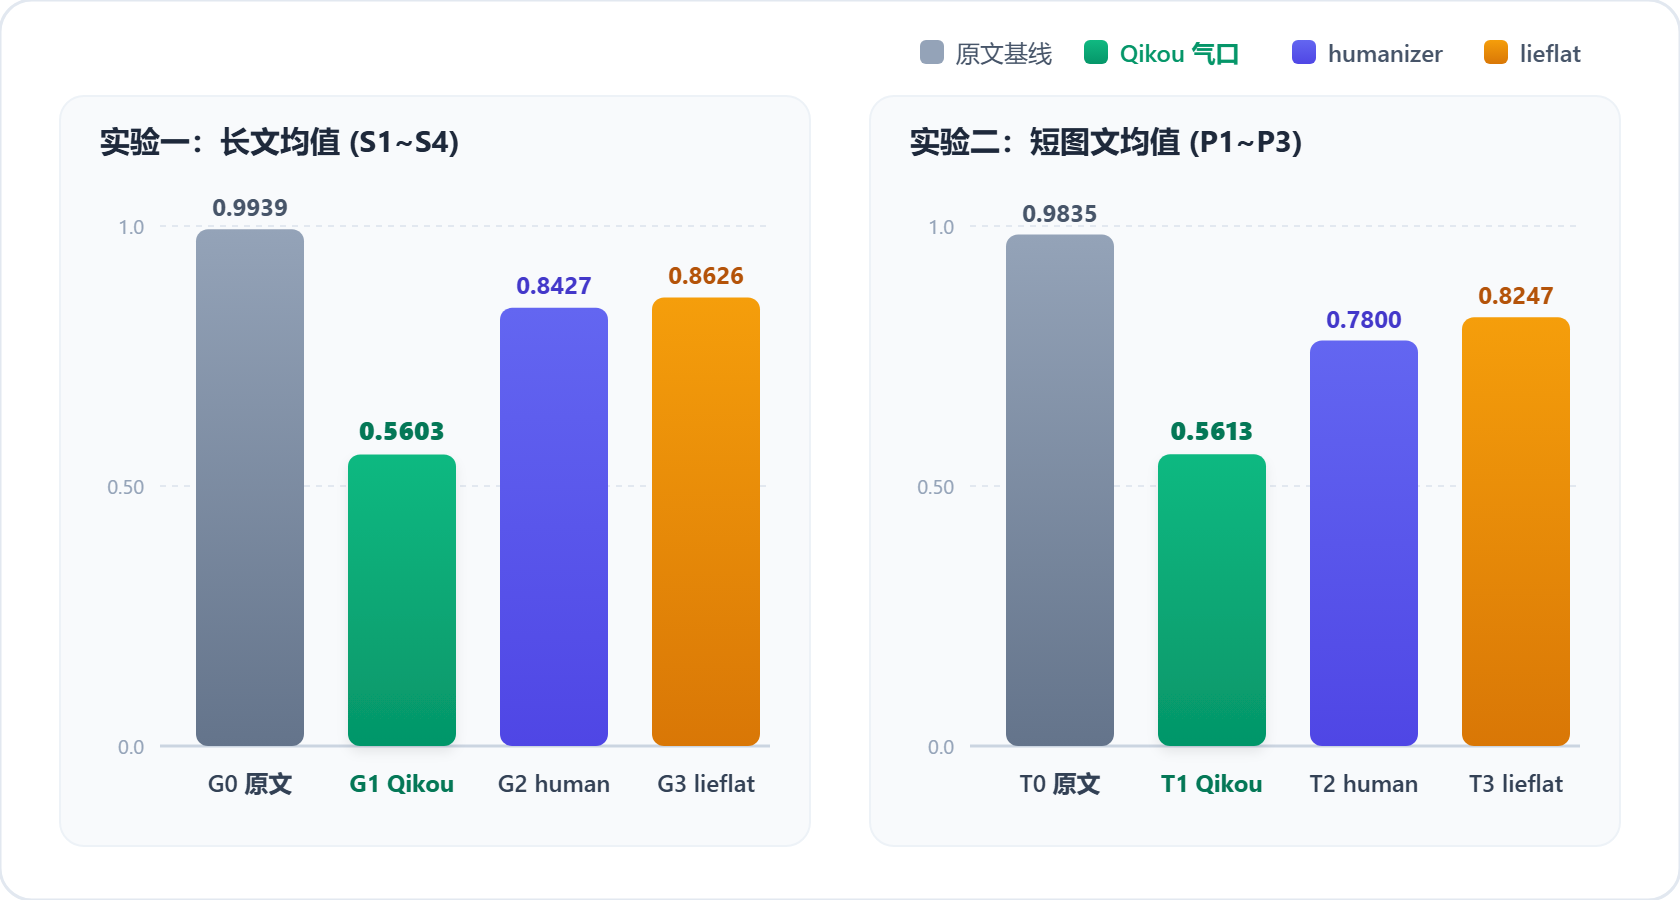
| 平均置信度 | 0.9939 |
0.5603 (降 43.6%) |
0.8427 (降 15.2%) |
0.8626 (降 13.2%) |
在叙事细节相对具象的 S3 片段中,Qikou 凭借盲听重构将置信度打到了 0.0860,直接被朱雀分类器判定为 Label 0 纯人类创作。humanizer-zh 依靠局部精简也将得分压至 0.4077。
当进入抽象哲学概念密集的 S2 片段时,三款工具的得分全部悬在 0.97 以上的高位。看来,如果文本通篇堆砌概念,缺少落脚的细节,单靠修剪字句或口语重述,还是很难撼动分类器的统计概率。
短文测试
找了 3 张带有对白字幕的视频截图,都是之前发过的,生成配图文案。
| 测试样本 | 原文基线 | Qikou | humanizer-zh | lieflat-less-ai-tone |
|---|---|---|---|---|
| P1(人机并跑) | 0.9810 |
0.2986 |
0.7184 |
0.7122 |
| P2(冥想心智) | 0.9766 |
0.6185 |
0.6225 |
0.7644 |
| P3(金钱心理学) | 0.9930 |
0.7667 |
0.9991 |
0.9975 |
| 平均置信度 | 0.9835 |
0.5613 (降 42.9%) |
0.7800 (降 20.7%) |
0.8247 (降 16.1%) |
短文精炼,语法框架更容易显得僵硬。在 P1 样本中,Qikou 通过口语化事实串联,将置信度降至 0.2986,同样进入了 Label 0 纯人类创作区间。
在 P2 样本中,humanizer-zh(0.6225)与 Qikou(0.6185)的效果基本相当。面对浮夸成语与套路连接词构成的轻度病灶,轻量级的局部规则修剪同样能干脆利落地见效。
文本细读
以 P2 为例,不同工具在微观层面的处理思路截然不同。
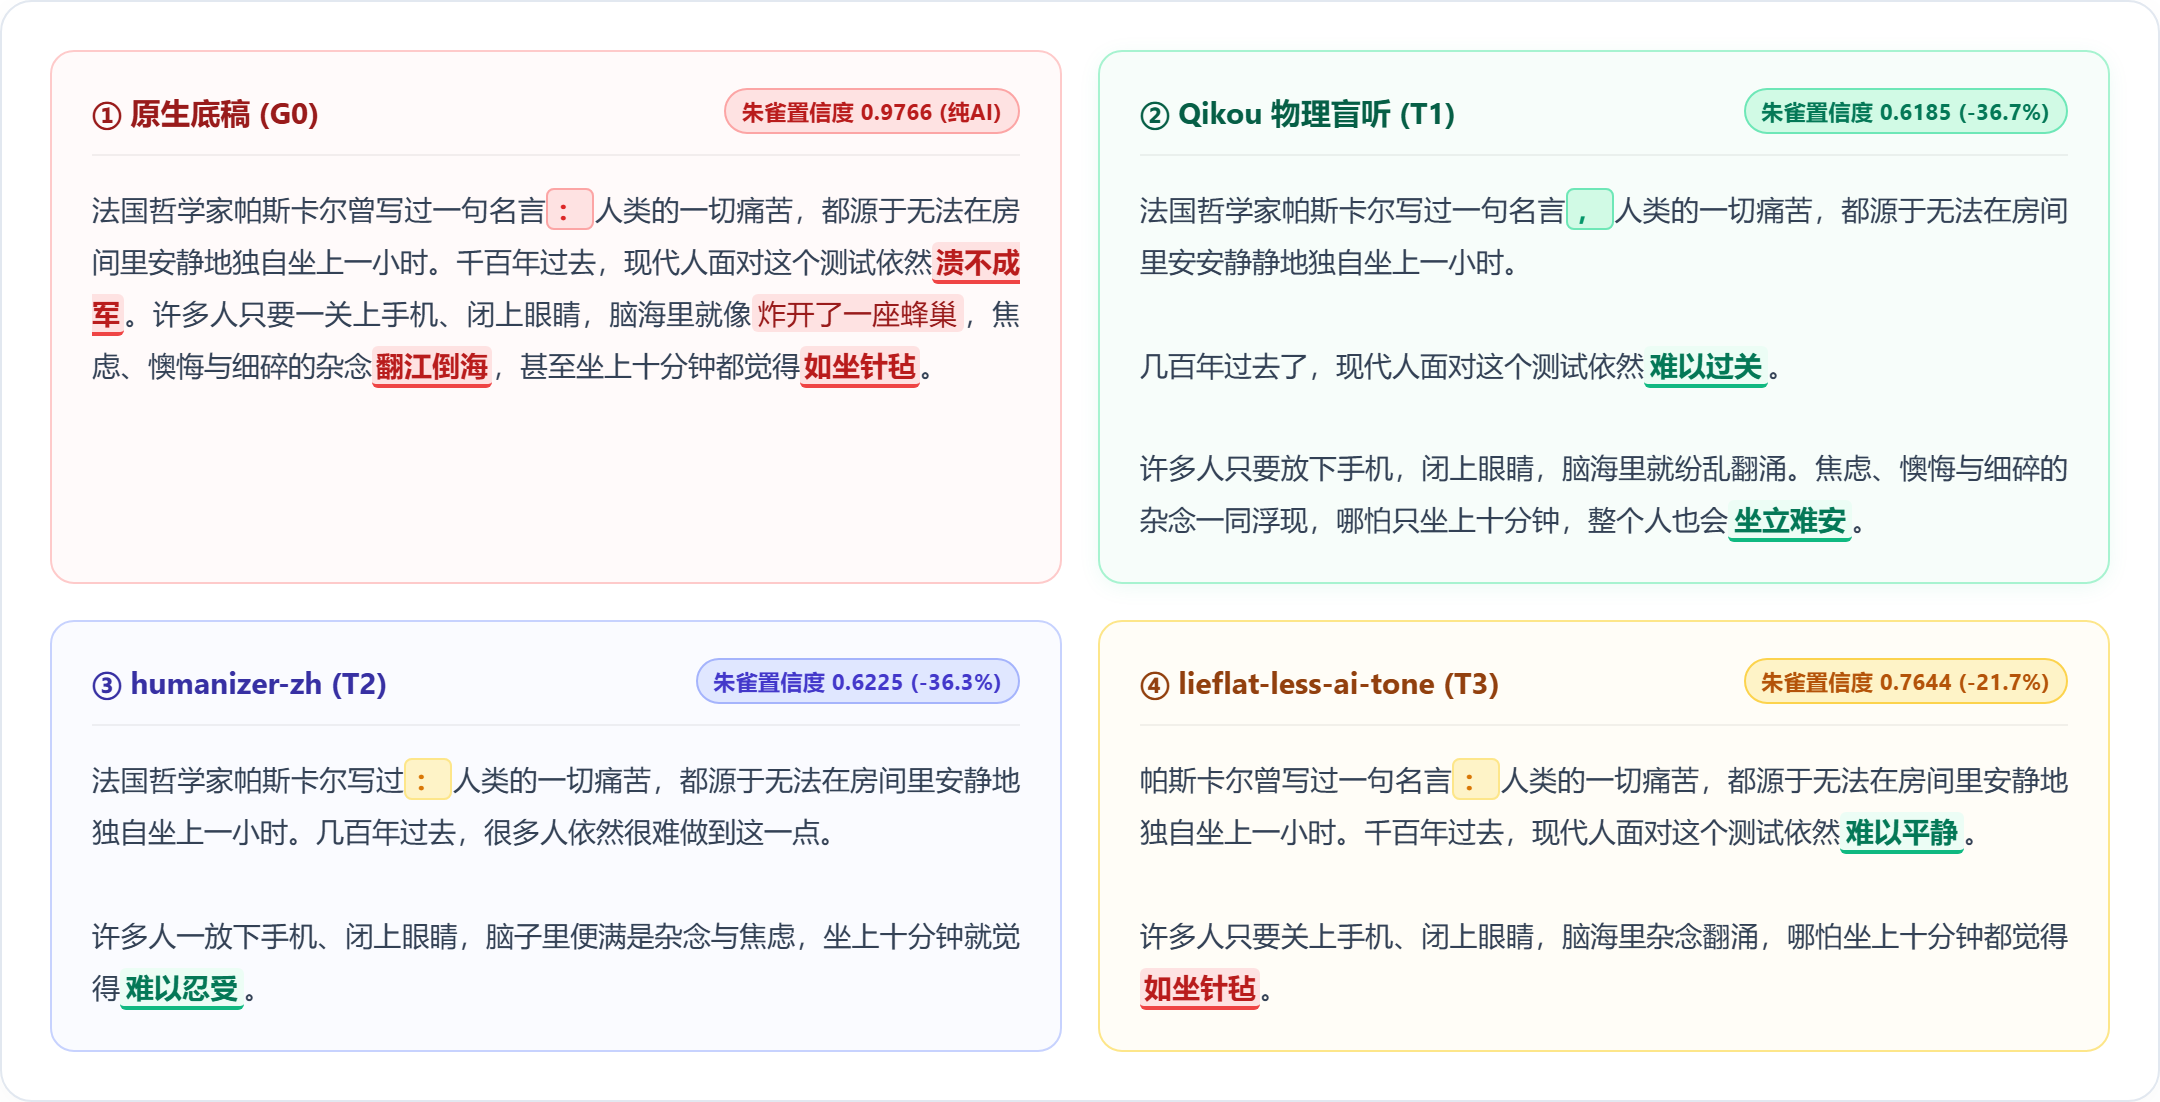
底稿是典型的 AI 生成文字。首句使用冒号强行报幕,“溃不成军”、“翻江倒海”、“如坐针毡”三个四字成语在紧凑节奏中密集轰炸,读者在默读时几乎找不到停顿换气的地方。
Qikou 拆掉了报幕式冒号,用逗号承接引用,“翻江倒海”、“如坐针毡”替换为“难以过关”、“坐立难安”等平实口语。通过合理切分句子留出自然的呼吸间隙。
humanizer-zh 极度利落,直接剔除掉蜂巢等夸张文学比喻,保留事实主干,文字压缩得很干净。
lieflat-less-ai-tone 走稳健的修复路线,替换词汇,尽量不动原有语序。
结语
必须如实交代,有不少案例使用三个技能都无法让 AI 率下降分毫。这些无效案例就不写在这浪费大家时间了。
降 AI 率的前提,是内容本身得有一定的信息量在。很遗憾,有些内容不管怎么换词,都是行不通的。
AI 率就像是进阶版的图灵测试,只是判断者被替换成了机器。
所以,我也不认为降 AI 率是很要紧的事,AI 并没有反感 AI 味,你让它判断做什么呢,能让自己读起来不难受就行了。
Qikou 工作流与脚本已开源至 GitHub:Joffoo/qikou