省流:AI 翻译长篇文本时容易前后翻译不一致,前面是施瓦辛格,后面是舒华辛力加。怎么办,我们切片翻译,提示词里配上术语表就行。
我的方式不是快捷方式
所以,我在思索什么。
之前用过一些开源翻译项目,总觉得按钮太多无从下手,功能很是全面,而且你都用开源项目了,乐趣不就是在 DIY 吗?
不是,其实是在读书吧。
当时的项目会让你自己填写术语表,可术语表是什么呢,从哪里来呢?
好在我能识文断字,知道术语表就是事先记录一套翻译规范,让 AI 只翻译成施瓦辛格、迈克尔·杰克逊和好莱坞,这样译文中就不会出现舒华辛力加、米高积逊和荷里活。
短文没有不一致的问题,但长文会有,因为 AI 也记不住这么多东西,所以需要把长文章切成短的片段喂进去,也要顺便附上所谓术语表。
道理很简单,我当时会把 EPUB 文件传到 AI 聊天框,让它总结出全书的术语表。但想也知道不全面,正如前面所说 AI 的注意力有限,聊天框里的也是,所以它并不会看完全书,然后气贯长虹地吐出完整术语表,不会的。
后来有了专门用来提取术语表的本地小模型。提取出来确实相当全面,有的没的一堆,除了有用的,就是没用的。
正如前面所说 AI 的注意力有限,这么长的术语表直接交给 AI,它还能完成翻译任务吗?所以我还要自己去筛选哪些是真正有用的,哪些是应该删掉的。
我前面忘说了,我的注意力也是有限的。
我开始对提前跑一遍术语表感到厌烦。当然你也可以用大模型跑一遍术语表,像翻译一样,先切片后处理,但这种浪费也使我厌烦。
我的思路是,先切片,AI 处理的时候先翻译,后记录下这一段有哪些新词要写入术语表。这就可以了,术语表可以动态累积,翻译和提取术语表可以同步进行,又方便又节约 token,岂不是很好。
更有趣的是,AI 新增的术语可以检索一下后文,如果没有再出现,那就不需要存入术语表(详见TransLit:AI 翻译电子书之我见)。
但总是要有代价的。
如果你用过这套方法,可能会嫌太慢,因为那些由你提供术语表的项目,分完片之后是可以一起操作的,毕竟参考的术语表都是全本的、一致的,这叫并行计算。
我还是接受了这一套方法,虽然不是很快,但也比我读得快多了。翻译的效果使我满意,独立想出这个思路也使我自喜。就在今年五月份我还一口气发了两篇相关的公众号文章,我的公众号关注者甚少,但这两篇阅读量都上千了,是我阅读量最高的文章。
我的方式不是我的方式
后来村上春树在七月份发表了一本小说《夏帆》,主角是女插画师,我还记得书里有食蚁兽。
这本书在发表的那天晚上,Z-library 就有人给了 AI 翻译的版本。直到现在,你也搜不到日语原版,只有各种中文翻译版挂在上面。人们几乎是清一色的好评,说是终于读到没有译者味的村上春树作品了。
后来有人认领了,推出了一个开源项目 Wenyi。我偶然发现撞了思路,都是边翻译边补充术语表。
我知道,也写明白了,如果你不想先跑一遍术语表,你就没有第二种选择,所以“我的方式不是我的方式”——当然不是我的方式,这是谁都能想到的路子,我很能接受这一点。
况且 Wenyi 没有在处理新增术语时检索后文,所以我还是有自己的东西在。
但我却开始进一步创新了。注意,后面的思路请不要学,哪怕是管用的思路,也不要学。
我的想法是,把新增的术语全放进提示词里,哪怕用后文是否出现过也还是有些多(就好像我天天翻译品钦一样),需要进一步优化。任务有相似性,能在后文搜索就能在当前分片搜索,这一下子,术语表就能再短上很多,再节省一些 token。
面向小红书编程之后,评论区有人回复说,理论很丰满,现实你会遇到屈折语。
我是第一次遇到这个词,大意就是单词的变化不是规则的,你用关键词匹配,估计匹配不上。
见招拆招,我给项目补上了模糊搜索,看上去没有什么问题。但现实让我看到的不是屈折语,而是平假名和片假名,我也不知道这本小说为什么会这么写。一开始加进术语表的是平假名写法的名字,分片里却只出现片假名的名字,这时候匹配不上,术语表缺了一块,随后 AI 还会贴心地补充上片假名的名字,于是术语表里就出现了两个人名,一个“悠儿”,一个“佑二”。
搜索后文和搜索当前分片之所以不是一回事,是因为能搜索的空间大小不一样,很多词不会同时以两种形式出现在同一个分片里。
于是我选择了放弃。
仔细想一下,漏洞是可以继续补的,比如人名地名之类的可以常驻术语表,剩下的部分模糊搜索也没有太大问题。我也实际测试过,没有太大问题,但还是放弃了。
正如前面所说的,我的注意力是有限的,token 的成本不过降低了几块,但是译本却出现了硬伤,哪怕只是有了这种风险,对我来说也是不能接受的。
我的方式是适合我的方式
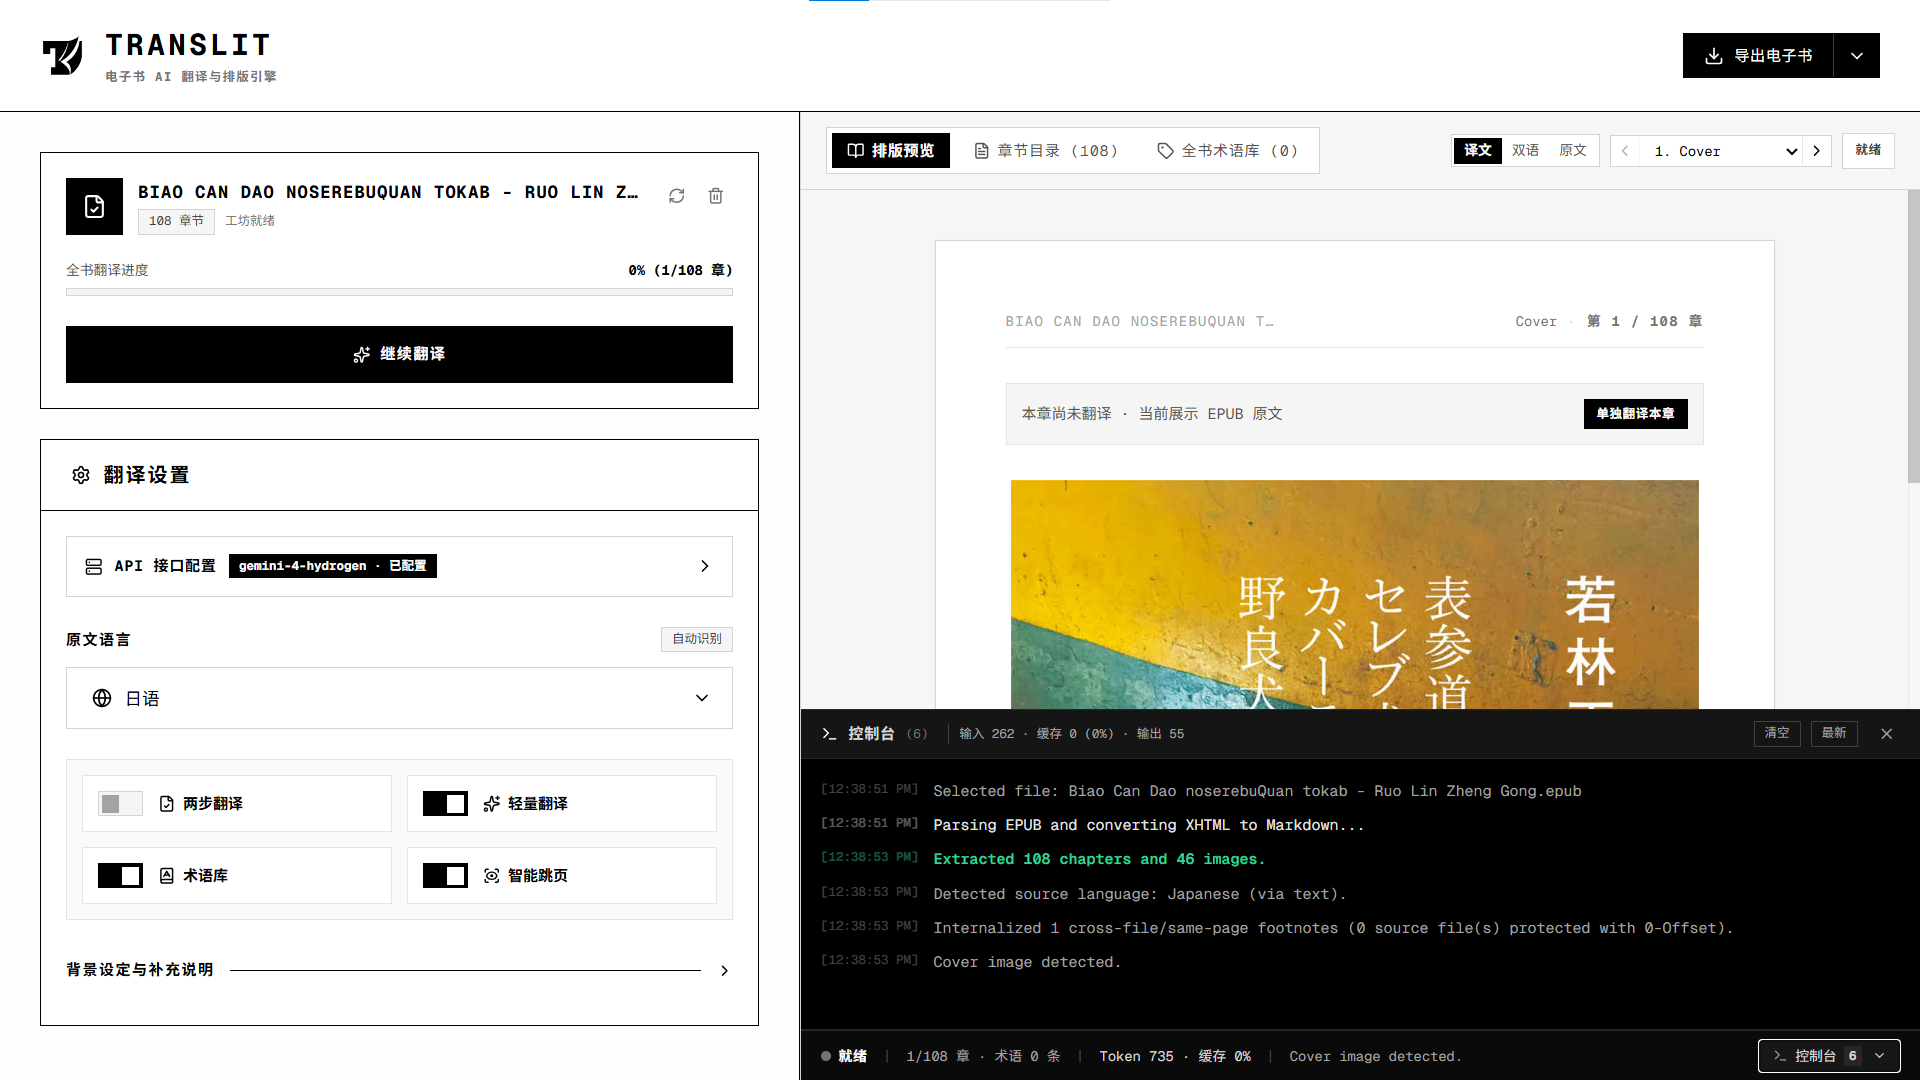
我要接受做东西没有人用,既然你没有往有人用这个角度努过力。
我也要接受公众号文章没有推荐——那就是没有阅读量了,对我来说也是正常的状态。
同样,我接受了现在这个翻译工作流,虽然不是最优化的方案。当然在此基础上,可以做一点引入风险的优化。
可以用最小 token 量表示术语表,比如 Finnegans = 芬尼根,Alex = 亚历克斯 (女)。
还可以调整一下提示词顺序,从静到动排列,这样可以提升缓存命中率:
- 翻译提示词
- 动态术语表
- 待翻译分片
不过,我竟然变得很少读小说了,术语表系统都用不太上了。
当我打磨工具,打磨得像是一种自用的产品时,我的注意力被牢牢锁在了上面。我不知道是好还是不好,但有一点是确定的:
我的注意力是有限的,相当有限的。
后续我还会分享围绕 AI 翻译工具 TransLit 的其他细节,包括如何更好地排版、如何处理弹注、如何导出原文对照版和微信读书适用的版本。
我的更新是你关注的最大动力。
