我读过研究生,后来也当过论文编辑,AI 率一直是一种“惘惘的威胁”。
编辑部会让助理编辑通过几种渠道计算 AI 率,但没有人知道算出来的是什么,只知道测出来 AI 率高,就要发邮件联系作者。
但我感觉连这一步都多余,因为作者只要回复说用 AI 翻译或者润色过,也就没有什么可说的了,最多让作者在“致谢”里加上一句。
这引出了两个疑问:
第一,先不讨论检测软件算出来的数值,为什么我们在读大模型写出的文字时,常会觉得别扭、费劲?
第二,网上很早就流传一种给论文降重的方法,即把中文翻译成外语,再从外语翻译回中文。在大模型普及后,不少人把这种“回译”当成去掉 AI 味的技巧。既然作者常拿“用 AI 翻译过”当解释,那回译到底能不能改变文本的 AI 特征呢?
论文里的观点:AI 为什么把句子写得绕口?
最近纽约大学和得克萨斯大学奥斯汀分校发了一篇预印本(Why is AI-generated language so hard to understand?, arXiv:2610.29162)。虽然这篇论文给出的不是定论,但它对我们理解这种“难读”很有参考价值。
论文作者分析了多个主流大语言模型在聊天、写代码和议论文写作中的语料,指出大模型频繁使用几类容易增加人类阅读负担的英文句法特征:
- 省略关系代词的定语从句:在从句中省略 that/which 等连接词,使读者缺乏句法缓冲。
- 无生命主语搭配通常属于人类或生物的动作:例如用抽象名词去作为具体动作的主语。
- 多个名词连续堆叠:将两三个名词连在一起使用,缺乏介词连接。
- 把名词直接当动词使用。
- 较长的句法依赖:主语与核心谓语动词之间插入了较长的修饰成分。
为了检验这些特征究竟是因为“话题本身太难写”,还是“模型主动选择”,论文作者做了一个英日回译实验:把 AI 写的英文通过机器翻译翻成日语,再从日语翻译回英文。
结果显示,回译之后的文本表达了同样的意思,但上述那些绕口的句法特征明显减少了。论文作者据此推测:同样的意思本可以用更平实、常规的句式表达,是模型在生成时主动偏向了这些更绕口的句法。
对于背后的原因,论文提出了一种解释,这与人类的语言习惯以及大模型的训练方式有关。
人类在日常沟通中,习惯把信息均匀分布在各个句子中。这在语言学上叫“均匀信息密度假说”(UID)。多说一两个过渡词,是为了配合听者有限的短期记忆,让人脑有时间缓冲和消化。
但现代大模型的优化目标却恰恰相反。
大模型在基础预训练完成后,会经历“后训练”(Post-training)阶段。早期的后训练主要依赖人类反馈强化学习(RLHF)——由人类标注员给模型的回答打分,教模型说更通顺、更有礼貌的人话。
但随着模型需要解决更复杂的数学推导和代码任务,训练范式逐步转向了基于可验证奖励的强化学习(RLVR)。在这一阶段,不再由人类主观打分,而是由代码测试或数学题的标准答案进行客观奖惩。
与此同时,模型还受到上下文窗口大小以及“长度惩罚”等机制的约束。在必须做对难题、又必须控制篇幅的压力下,模型逐渐摸索出了一种高信息密度的表述策略。
为了用尽量少的 Token 塞进同样的信息,模型开始主动省略“因此”、“从而”等起缓冲作用的连接词,把长动作压缩成多层嵌套的名词短语,甚至把名词直接当动词用。
一篇文章翻看下来,满眼是紧绷的句子,缺少呼吸的节奏。
中文回译实测:它真的能去掉 AI 味吗?
论文观察到的是英语中的微观句法现象,那在中文语境下,把文本翻译成外语再译回中文,能否改变检测软件的判断?
我做了一组对照实验,记录回译前后字符数、Token 数量的变化,并观察腾讯朱雀 AIGC 检测接口给出的数值。
1. 实验素材与工具
测试选取了三篇由大模型(Gemini 3.8 Flash)直接生成的中文文本,涵盖三种常见类型:
- 算法说理(哈希表树化机制分析,387 字)
- 公文写作(制造业数字化转型报告,444 字)
- 文学随笔(深秋早晨菜市场白描,369 字)
作为人类写作的参照,同时选取了两个出版译本的片段:海明威《老人与海》(樊飞玉译,412 字)与约瑟夫·德夫林的《英文写作课》(309 字)。
翻译工具选用 DeepL,分别测试“中文 $\to$ 日文 $\to$ 中文”和“中文 $\to$ 英文 $\to$ 中文”两条路径。
之所以不用对话式大模型,是为了避免模型在翻译过程中主动改写内容,只保留机器翻译在跨语言转换时对句式的被动调整。
2. 两个观测指标
实验主要记录两项数据:
- Token 数与膨胀率:使用
cl100k_base编码器统计回译前后的 Token 变化,观察句子是否在语义空间中变长。 - 腾讯朱雀检测数值:调用朱雀 AIGC 接口获取置信度(0 到 1)。数值越接近 1,判定为 AI 生成的确定程度越高;越接近 0,越倾向于人类写作。
实测结果:句子舒展了,但朱雀不认
实验的测试数据如下:
| 样本类别与编号 | 文本主题 | 处理条件 | 字符数 (变动) | Token 数 (膨胀率) | 朱雀 AI 置信度 |
|---|---|---|---|---|---|
| AI 原生:算法说理 (S1) | 哈希表树化分析 | 原始文本 | 387 字 | 434 T | 0.9979 |
| 中 $\to$ 日 $\to$ 中 | 445 (+58) | 478 (+10.1%) | 0.9981 | ||
| 中 $\to$ 英 $\to$ 中 | 478 (+91) | 518 (+19.4%) | 0.9974 | ||
| AI 原生:公文写作 (S2) | 数字化转型分析 | 原始文本 | 444 字 | 530 T | 0.9960 |
| 中 $\to$ 日 $\to$ 中 | 539 (+95) | 612 (+15.5%) | 0.9964 | ||
| 中 $\to$ 英 $\to$ 中 | 524 (+80) | 600 (+13.2%) | 0.9988 | ||
| AI 原生:文学随笔 (S3) | 菜市场白描 | 原始文本 | 369 字 | 597 T | 0.9994 |
| 中 $\to$ 日 $\to$ 中 | 454 (+85) | 717 (+20.1%) | 0.9979 | ||
| 中 $\to$ 英 $\to$ 中 | 470 (+101) | 723 (+21.1%) | 0.9988 | ||
| 人类对照:名家译文 (S4) | 《老人与海》出版译本 | 原始文本 | 412 字 | 579 T | 0.0011 |
| 中 $\to$ 日 $\to$ 中 | 428 (+16) | 607 (+4.8%) | 0.0819 | ||
| 中 $\to$ 英 $\to$ 中 | 427 (+15) | 589 (+1.7%) | 0.0022 | ||
| 人类对照:名家译文 (S5) | 《英文写作课》出版译本 | 原始文本 | 309 字 | 425 T | 0.0010 |
| 中 $\to$ 日 $\to$ 中 | 321 (+12) | 441 (+3.8%) | 0.0152 | ||
| 中 $\to$ 英 $\to$ 中 | 316 (+7) | 433 (+1.9%) | 0.0018 |
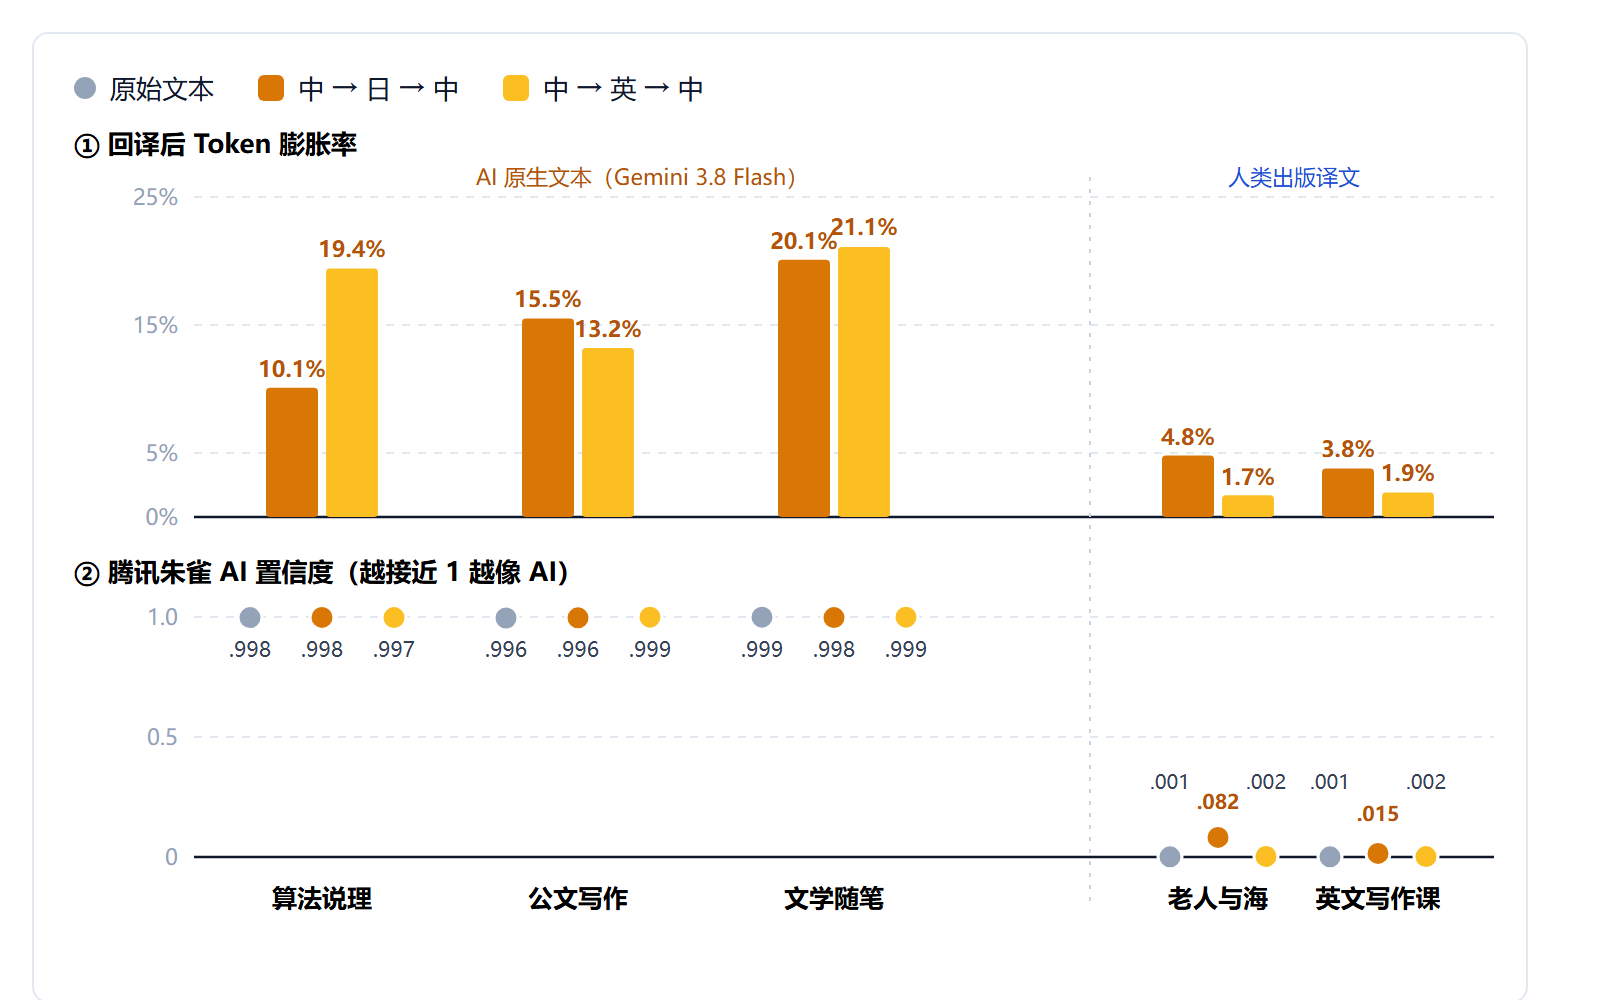
实测数据呈现出几项清晰的结果:
事实一:AI 翻译人类文本,不会产生高 AI 率
在对照组中(不是图中的实验结果),我让大模型直接翻译《老人与海》和《英文写作课》的英文原文,测出的朱雀数值分别为 0.0020 和 0.0319。
这个数值与人类出版译文(0.0011 与 0.0010)处在同一水平,均被判定为人类写作。这说明只要底层的论述与表达逻辑源自人类,单纯经过机器翻译,检测器通常不会将其判定为 AI。
我的理解是,翻译任务的约束够强,让 AI 没有多少自由发挥、展示真我的空间。
如果让 AI 接着人类写好的前半段往下续写,这种约束还剩多少?
于是,我做了一个接力测试。底稿选用德夫林《英文写作课》中译本的前两段,文段的朱雀检测值只有 0.0010。
还是用 Gemini 3.8 Flash,让它模仿作者语言、顺着语境自然往下接。
随后我对不同文本切片做了检测:
| 测试切片 | 文本构成与来源 | 字符数 | 朱雀 AI 置信度 | 判定分类 (Label) |
|---|---|---|---|---|
| 基线 A:纯人类前半段 | 德夫林原著译文 | 309 字 | 0.0010 | Label 0(纯人类创作) |
| 测试 B:仅 AI 续写下半段 | Gemini 3.8 Flash 自由续写 | 259 字 | 0.9998 | Label 1(纯 AI 生成) |
| 测试 C:人机拼接全文 | 前半段人类 (54%) + 后半段 AI (46%) | 568 字 | 0.7498 | Label 2(疑似/人机混合) |
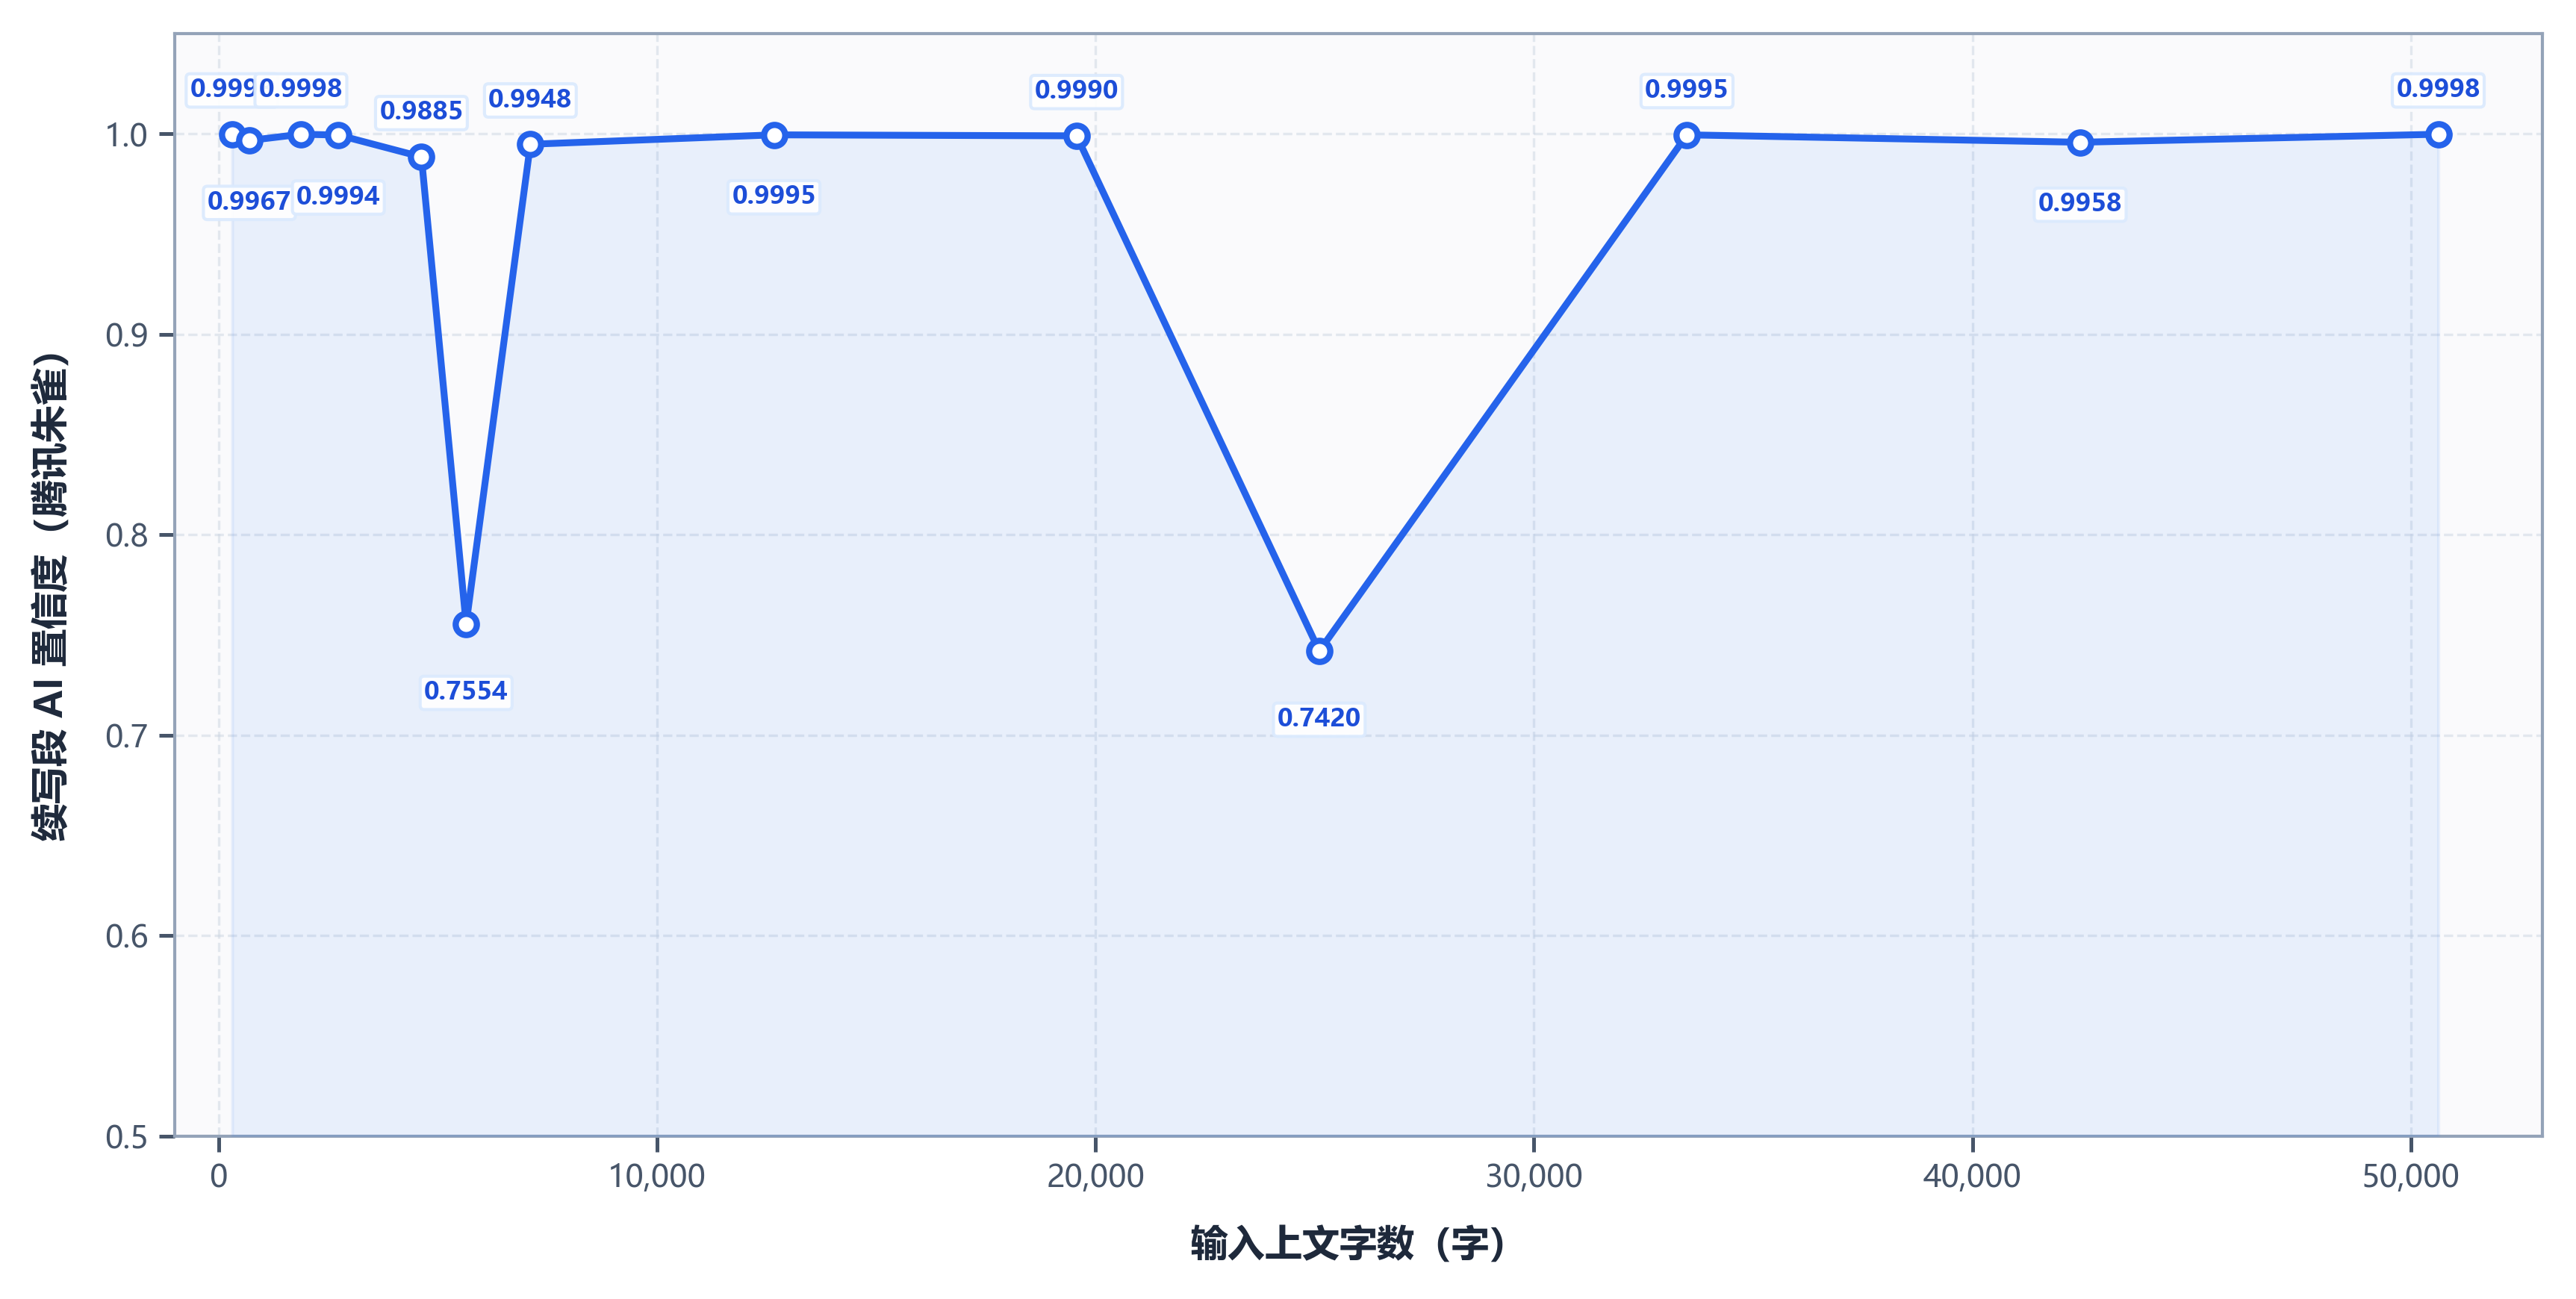
可以看到,如果不是翻译,只靠简短的原文约束根本不够,AI 的续写依然信马由缰。
这是不同上文字数得到的续写结果 AI 率的折线图,也没有呈现出下降趋势。
事实二:AI 文本回译后,Token 数明显增加
三篇 AI 样本经过回译后,Token 数量普遍增加了 10.1% 到 21.1%,字数净增 58 到 101 字。
对比之下,人类译者译文经过同样的回译,Token 仅增加了 1.7% 到 4.8%,字数变动只有 7 到 16 字。这与论文的观察高度吻合:AI 原生文本的信息往往被高度压缩,机器翻译在跨语言转换时,会将原本紧凑的句式逐步展开。
事实三:回译对降低 AI 检测率没有效果
无论字数增加了多少,三篇 AI 原生文本在回译后的朱雀检测数值始终维持在 0.9964 到 0.9988 之间,几乎没有变动。
文本对比:回译改变了什么?
仔细对照回译前后的具体句子,能清楚看到文本层面的变化。
比如 S1 样本中,AI 原始句为:
“空间维度上,红黑树节点占用内存约是链表节点的两倍(增加了父节点、左右子指针及颜色位),初始即用树结构会造成严重的内存浪费。”
经过回译后,句子被转译为:
“从空间角度来看,红黑树节点占用的内存约为链表节点的两倍(因为增加了父节点、左右子节点指针以及颜色位),如果一开始就使用树结构,将会导致严重的内存浪费。”
DeepL 翻译时受限于目标语言语法,通常无法完整保留中文里复杂的复合名词短语,因而拆解了结构,补上了“从……角度来看”、“因为”、“如果……将会”等连接词与标记。这也是回译后 Token 增长 10% 到 20% 的主要原因。
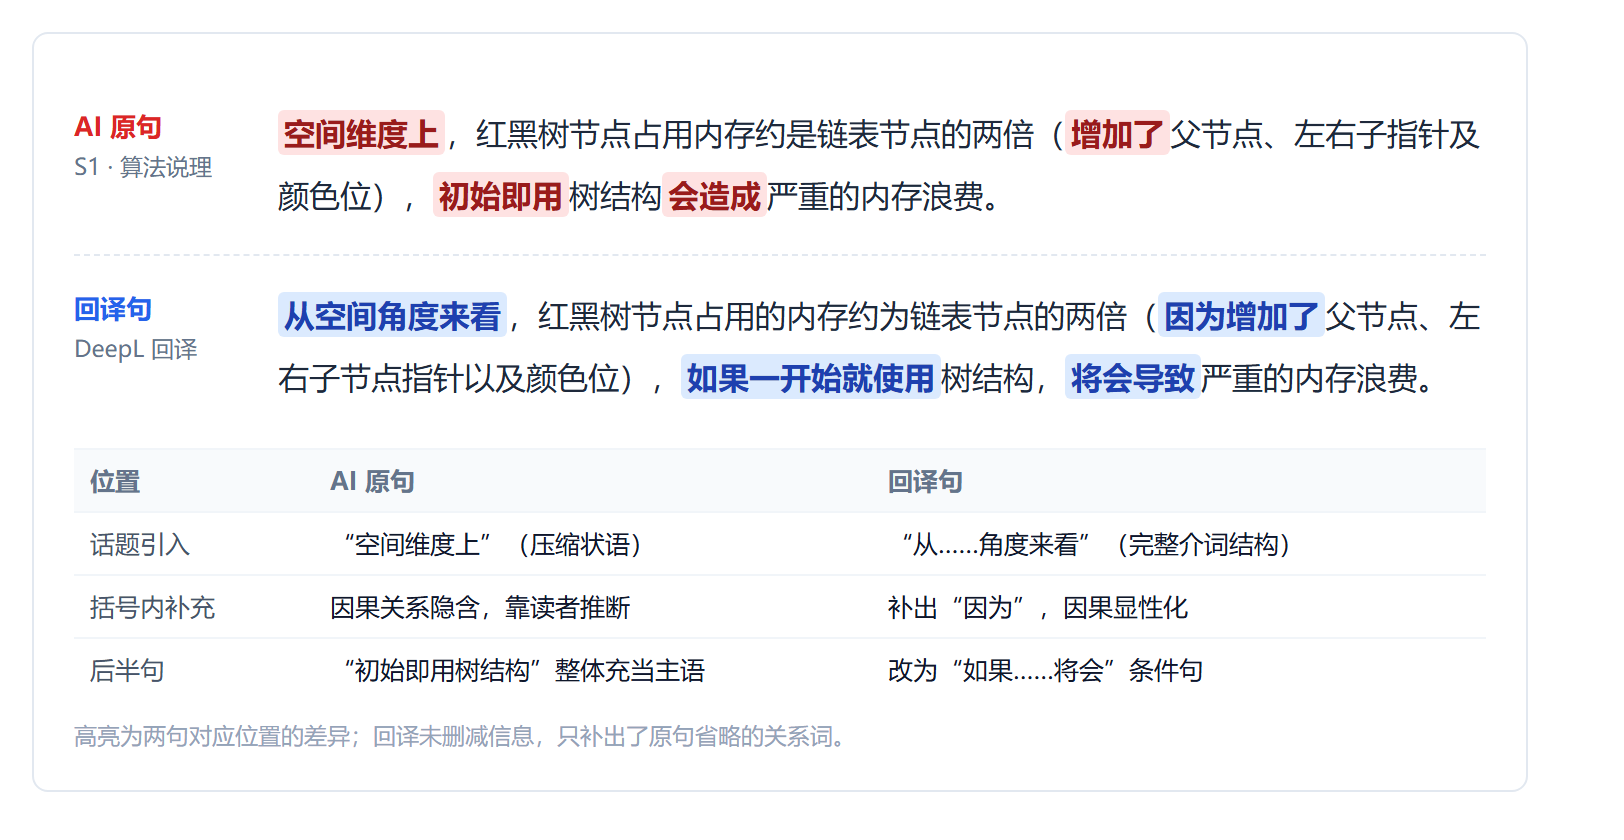
单看局部,句子读起来确实顺畅了一些,不再那么紧绷。
有趣的是,在文学随笔 S3 样本中,回译也带来了词义偏差的问题。例如原文中的“老面馒头”,在日文回译中变成了“天然酵母馒头”,在英文回译中则变成了“酸面团包子”……
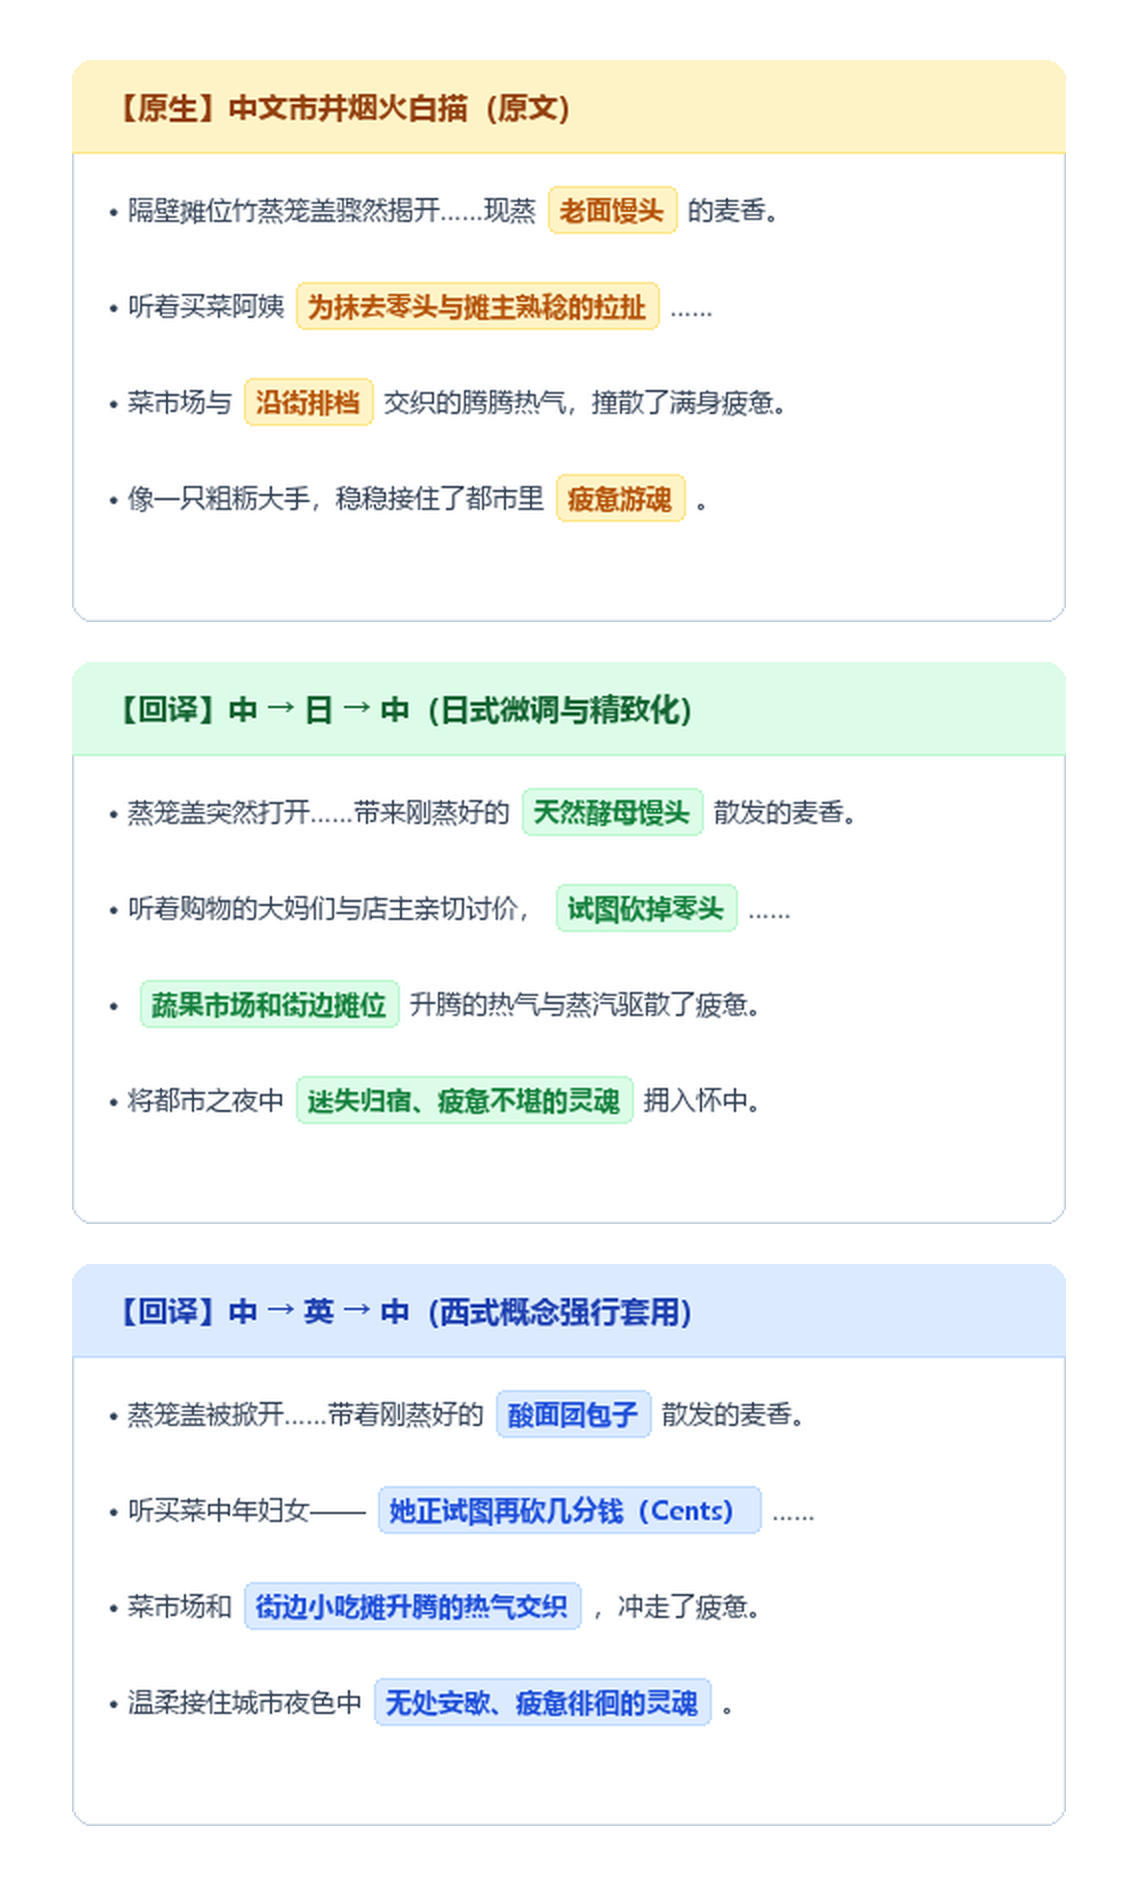
那么,既然句子拉长了,连词也补齐了,为什么朱雀依然判定为 AI?
回译确实打散了长定语、增加了关联词,降低了局部的理解成本。但像朱雀这类基于神经网络的检测模型,关注的重点往往不是局部的连接词或定语长度,而是更为抽象的统计分布。
翻译工具为确保译文通顺,倾向于选择常见的高概率词汇组合,缺少人类自然写作中常见的起伏与停顿。因此,回译虽然改变了句子的外部形态,却没有实质改变模型生成文本时的统计特征。
这也说明,基于全局统计特征的神经网络检测模型,很难通过简单的机械规则加以绕过。即使某些局部调整在特定段落中短暂降低了数值,换一段往往就会失效。
小结
回到开头提的那两个问题,结合论文和实测,大致可以得出这么几点结论:
- AI 写的东西难读,往往是因为句子被过分压缩了。在强化学习和长度限制的训练下,模型习惯把信息高密度地塞进句子,缺少人类日常表达里应有的缓冲节奏。
- 拿“AI 翻译过”当借口并不成立。如果底稿由人类写成,单纯交给 AI 翻译,并不会被测出很高的 AI 率;相反,如果是 AI 原生写出的文本,不管怎么翻译、回译,都掩盖不住 AI 特征。
- 回译能改善句式,但骗不过检测软件。通过中英或中日回译,机器翻译确实会把被压缩的短语拆开、补上关联词,让句子读起来没那么紧绷(Token 普遍膨胀了 10% 到 20%)。但像朱雀这样的检测器识别的是深层的词汇统计概率,而不是表面字数。句子舒展了,底层的“AI 味”依旧在。
之后,我(估计)还会继续尝试网上流传的其他“去 AI 味”方法,看看到底效果如何。如果你也对 AI 味问题感兴趣,欢迎关注。
参考文献
1. Why is AI-generated language so hard to understand? (arXiv:2610.29162): https://arxiv.org/abs/2610.29162 ↩
2. [美] 欧内斯特·海明威 著,樊飞玉、陈鹏 译.《老人与海:中英对照彩绘珍藏版》. 化学工业出版社, 2017. ISBN 978-7-122-27461-8 ↩
3. [爱尔兰] 约瑟夫·德夫林 著.《英文写作课:如何读,如何写?(中英文对照)》. 黑龙江美术出版社, 2020. ↩
